Il y a quelques semaines, j’avais partagé mon side-project open-source PodCraft AI (voir mon précédent post ici), un pipeline entièrement serverless sur AWS qui transforme automatiquement une veille d’actualités en épisode de podcast quotidien publié sur Spotify (avec Google Gemini pour la synthèse et les voix TTS, AWS Lambda + FFmpeg Docker, et Step Functions pour orchestrer le tout).
Le projet tourne bien pour l’audio, mais je voulais générer de véritables vidéos et des déclinaisons Shorts/TikTok avec avatar animé, synchronisation labiale (lip-sync) et rendu correct.
Et surtout, le faire pour 0 € de coût récurrent en génération vidéo car je suis fauché.
Le mur financier de la vidéo IA dans le Cloud#
Générer un petit clip de 5 secondes pour tester une API, c’est amusant. Mais générer des vidéos longues quotidiennes (5, 10, 15 minutes ou plus) avec des services Cloud, c’est un suicide financier pour un side-project :
- Les API SaaS (HeyGen, Runway, Luma, Veo) : elles facturent au crédit ou à la seconde/minute. Pour un format long quotidien, la facture grimpe rapidement à plusieurs centaines voire milliers d’euros par mois, avec en prime des limitations strictes sur la durée maximale des vidéos et des pipelines en boîte noire fermée.
- Les instances GPU Cloud (AWS EC2 g5.xlarge / A10G) : à ~1,20 $ / heure hors taxes, plus le stockage EBS volumineux pour les checkpoints (20 à 50 Go), les démarrer à froid (cold boot de 5-10 min pour charger les modèles en VRAM) ou les laisser tourner en continu détruisait la promesse du serverless (“pay-per-use” et scale-to-zero).
=> pour générer du format long à volonté sans se ruiner, il faut rapatrier le calcul lourd sur du matériel dédié. J’ai donc opté pour une approche hybride : Cloud Serverless pour l’orchestration et le scraping + On-Premises pour le GPU.
Un serveur maison et une RTX 3090 dénichée sur Leboncoin#
Pour faire tourner des modèles vidéo IA en local sur des séquences longues, le facteur limitant numéro un n’est pas le processeur, mais la VRAM (mémoire vidéo).
Entre le modèle de génération vidéo (MiniMax / diffusion), les modèles de lip-sync haute fidélité (LatentSync) et l’upscaling en 1080p ou 4K, n’importe quelle carte graphique à 8, 12 ou même 16 Go de VRAM sature immédiatement et plante en Out Of Memory.
j’ai réussi à trouver une NVIDIA GeForce RTX 3090 avec ses 24 Go de GDDR6X pour un excellent prix. Les 24 Go de VRAM sont le véritable “cheat code” du machine learning local :
- On peut charger de gros checkpoints en mémoire sans quantification agressive.
- On peut enchaîner le rendu par morceaux (chunking) et le traitement lourd en continu.
- Le coût marginal d’une vidéo longue devient littéralement 0 € (hors électricité de la maison). Que mon épisode dure 2 minutes ou 20 minutes, je ne paie plus un seul centime d’API vidéo.
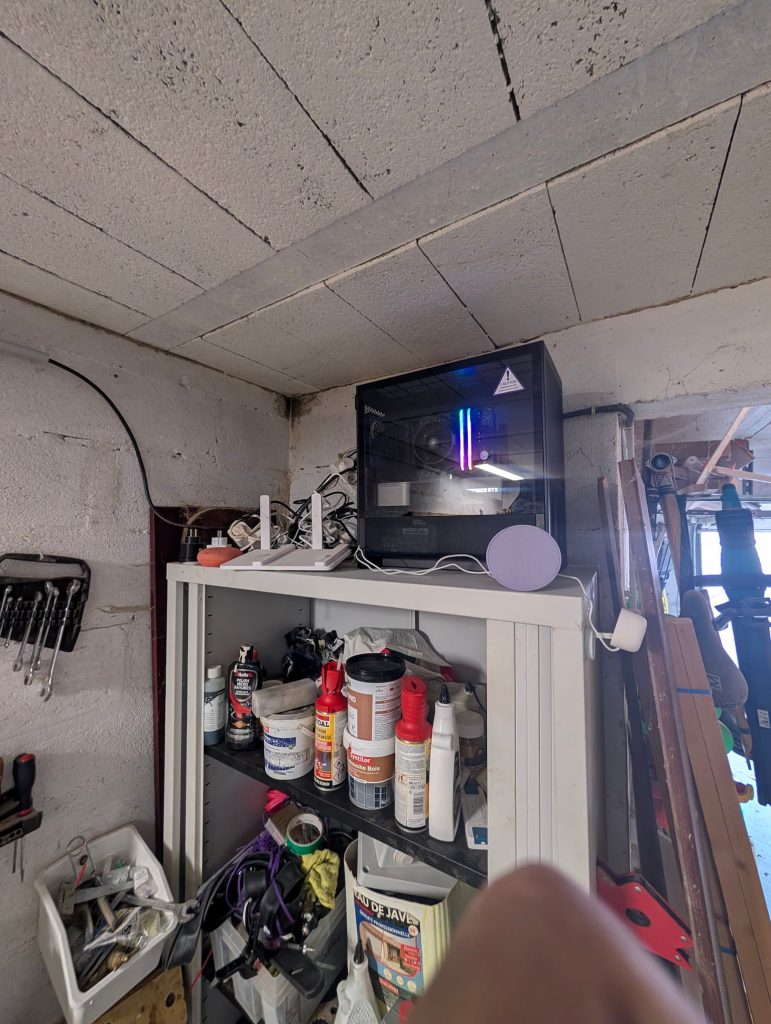
J’ai monté la carte dans une tour dédiée sous Linux (ubuntu server, qui est pas trop relou pour installer les drivers nvidia) qui tourne tranquillement chez moi.
Brancher une machine de salon à AWS sans bidouille réseau#
Avoir la puissance GPU à la maison, c’est bien. Mais comment faire communiquer un orchestrateur Cloud (AWS Step Functions) avec une machine physique posée derrière la box Internet du salon ?
contraintes strictes :
- Zéro port ouvert sur la box : hors de question de faire du port forwarding ou d’exposer une API sur ma connexion résidentielle.
- Pas d’IP publique fixe requise : la box peut changer d’IP sans jamais impacter la production.
- Zéro coût d’attente sur AWS : le rendu d’une vidéo longue prend du temps (plusieurs dizaines de minutes selon la durée et le nombre de plans). Hors de question d’avoir une Lambda qui tourne dans le vide à attendre la fin du rendu (timeout max de 15 min de toute façon, et facturation à la milliseconde).
- Résilience : si le serveur local est éteint ou redémarre, le job ne doit pas être perdu et doit attendre son tour.
La solution idéale existe nativement dans AWS : le pattern waitForTaskToken de Step Functions, couplé à une file Amazon SQS.
Le cœur de l’architecture : Le patternwaitForTaskToken#
Dans AWS Step Functions, vous pouvez appeler un service (ici SQS) en mode asynchrone avec accusé de réception différé grâce à la ressource : arn:aws:states:::sqs:sendMessage.waitForTaskToken.
Comment ça marche concrètement ?#
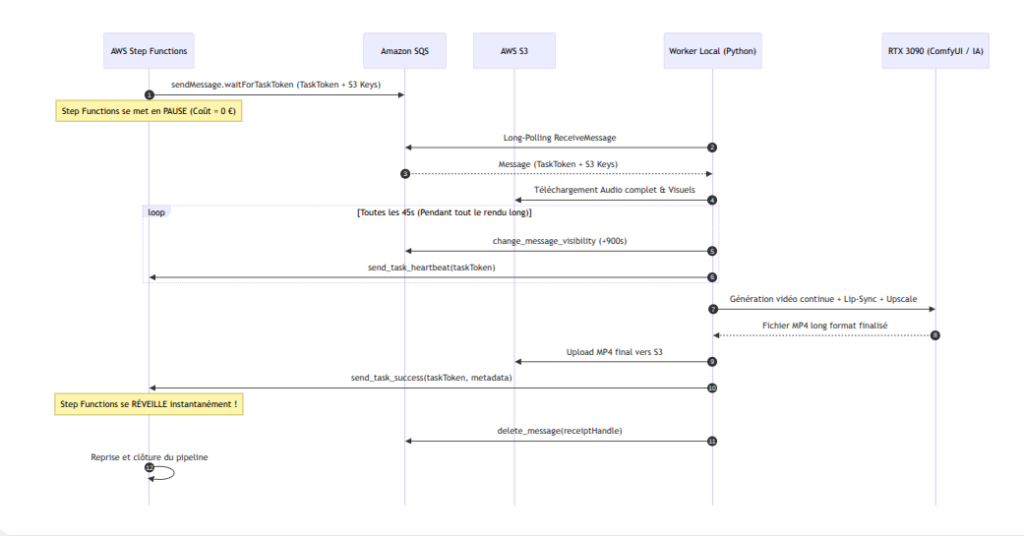
- Step Functions dépose un message dans SQS : Dans le corps du message, Step Functions injecte automatiquement une variable d’exécution contextuelle :
$$.Task.Token. C’est un jeton chiffré unique représentant l’instance exacte du workflow en cours. - Step Functions se met en PAUSE (Coût = 0 €) : L’exécution s’arrête sur cet état (
WaitForLocalWorker). Et c’est là toute la beauté du modèle Step Functions Standard : le temps d’attente ne coûte absolument rien (on ne paie que les transitions d’états, aucune facturation à la durée d’attente !). J’ai configuré unTimeoutSeconds: 7200(2 heures de marge). - Le Worker local dépile le message (Pull sortant) : Sur mon serveur local, un daemon Python sous
systemdeffectue du long-polling sortant sur la file SQS (ReceiveMessageavecWaitTimeSeconds=20). Comme c’est la machine locale qui initie la connexion HTTPS vers AWS, aucun port entrant n’est ouvert sur la box. - Maintien de la visibilité SQS & Heartbeats Step Functions : Pendant que la RTX 3090 calcule les différents segments de la vidéo longue, un thread d’arrière-plan (
MessageHeartbeatThread) s’exécute en parallèle :- Il renouvelle périodiquement le
VisibilityTimeoutdu message SQS (ex: +900s toutes les 45s) pour qu’aucun autre processus ne récupère le message. - Il envoie un heartbeat à Step Functions (
sfn_client.send_task_heartbeat(taskToken=token)) pour notifier à AWS que le job avance normalement.
- Il renouvelle périodiquement le
- Rendu vidéo long & Upload S3 : Le worker télécharge les assets depuis S3 (l’audio complet généré par Gemini TTS, le script, les visuels de référence). Le moteur local génère la vidéo, applique le lip-sync sur toute la durée, fait l’upscale, assemble le MP4 final et le téléverse sur S3.
- Le réveil instantané de Step Functions : Dès que le téléversement S3 est terminé, le worker appelle l’API AWS :pythonCopier
sfn_client.send_task_success( taskToken=task_token, output=json.dumps({"status": "SUCCESS", "video_s3_key": final_key}) )Instantanément, Step Functions reprend son exécution dans le Cloud, reçoit la clé de la vidéo générée, et enchaîne sur les étapes finales (publication Spotify / YouTube, notifications, etc.). - Acquittement SQS : Le worker supprime le message de la file SQS. Si la machine venait à crasher ou couper le courant en plein milieu, le token n’est jamais validé et le message redevient disponible dans SQS.
Schéma de la pipeline actuelle#
Voici l’architecture complète combinant le Cloud Serverless AWS et le serveur local :
Comment je sors des vidéos longues sans exploser la VRAM#
Générer une vidéo de 10 minutes d’un coup dans un modèle de diffusion saturerait n’importe quelle carte graphique. Voici l’astuce côté worker :
- Découpage audio & multi-plans : la piste audio est segmentée intelligemment. Le script génère plusieurs plans de caméra (face, léger profil, plan moyen) en réinjectant une image de référence (
refimage) pour garantir la cohérence absolue du personnage et de ses vêtements d’un plan à l’autre. - Génération continue & Lip-Sync par chunk : le moteur (MiniMax / ComfyUI) génère les séquences vidéo, puis ByteDance LatentSync 1.6 synchronise les lèvres de l’avatar avec une précision redoutable sur l’audio français.
- Upscale & Concaténation FFmpeg : chaque segment passe par un upscale
4x-UltraSharppour atteindre un rendu 1080p super net, puis FFmpeg assemble l’ensemble de manière transparente avec la piste audio complète.
La RTX 3090 encaisse le batching tranquillement avec ses 24 Go, sans saturation.
Bilan financier : La vidéo longue pour 0 €#
Voici le comparatif concret entre avant et maintenant :
| Poste de coût | Approche Full Cloud (SaaS / EC2) | Approche Hybride Actuelle |
|---|---|---|
| Génération Vidéo Longue | 200 € à 1 000+ € / mois (crédits HeyGen/Runway ou EC2 g5) | 0 € (Inférence locale sur RTX 3090) |
| Orchestration (Step Functions) | Élevé si polling ou Lambdas d’attente | ~0,01 € (Pause gratuite avec TaskToken) |
| Queue & Stockage (SQS / S3) | Quelques centimes | < 0,10 € / mois |
| Synthèse & TTS (Gemini) | ~0,50 € / jour | ~0,50 € / jour |
| Total Vidéo | Hors de prix en side-project | 0 € de coût API vidéo |
Retours d’expérience#
- La puissance du pattern
taskToken: c’est un game changer. Au lieu de voir le serverless comme une prison dorée où tout doit tourner sur Lambda en moins de 15 minutes,waitForTaskTokenpermet de transformer n’importe quel serveur ou cluster on-premise en extension naturelle de votre cloud AWS. - Résilience totale : si le serveur est éteint la nuit ou redémarre pour une mise à jour système, le message attend sagement dans SQS. Dès que le daemon se lance au boot, il prend le job et réveille Step Functions à la fin.
- Liberté totale sur les modèles : pas de filtre absurde d’API tierce, pas de compression agressive de bitrate, choix total des checkpoints, des LoRA et des upscalers.
Le dépôt GitHub est toujours disponible ici : https://github.com/bmallory/podcraft-ai
Leave a Reply