Blog

  • greffer du gros calcul local (RTX 3090 locale Leboncoin) à un pipeline 100% Serverless AWS avec les TaskTokens Step Functions

    Il y a quelques semaines, j’avais partagé mon side-project open-source PodCraft AI (voir mon précédent post ici), un pipeline entièrement serverless sur AWS qui transforme automatiquement une veille d’actualités en épisode de podcast quotidien publié sur Spotify (avec Google Gemini pour la synthèse et les voix TTS, AWS Lambda + FFmpeg Docker, et Step Functions pour orchestrer le tout).

    Le projet tourne bien pour l’audio, mais je voulais générer de véritables vidéos et des déclinaisons Shorts/TikTok avec avatar animé, synchronisation labiale (lip-sync) et rendu correct.

    Et surtout, le faire pour 0 € de coût récurrent en génération vidéo car je suis fauché.


    Le mur financier de la vidéo IA dans le Cloud#

    Générer un petit clip de 5 secondes pour tester une API, c’est amusant. Mais générer des vidéos longues quotidiennes (5, 10, 15 minutes ou plus) avec des services Cloud, c’est un suicide financier pour un side-project :

    • Les API SaaS (HeyGen, Runway, Luma, Veo) : elles facturent au crédit ou à la seconde/minute. Pour un format long quotidien, la facture grimpe rapidement à plusieurs centaines voire milliers d’euros par mois, avec en prime des limitations strictes sur la durée maximale des vidéos et des pipelines en boîte noire fermée.
    • Les instances GPU Cloud (AWS EC2 g5.xlarge / A10G) : à ~1,20 $ / heure hors taxes, plus le stockage EBS volumineux pour les checkpoints (20 à 50 Go), les démarrer à froid (cold boot de 5-10 min pour charger les modèles en VRAM) ou les laisser tourner en continu détruisait la promesse du serverless (“pay-per-use” et scale-to-zero).

    => pour générer du format long à volonté sans se ruiner, il faut rapatrier le calcul lourd sur du matériel dédié. J’ai donc opté pour une approche hybride : Cloud Serverless pour l’orchestration et le scraping + On-Premises pour le GPU.


    Un serveur maison et une RTX 3090 dénichée sur Leboncoin#

    Pour faire tourner des modèles vidéo IA en local sur des séquences longues, le facteur limitant numéro un n’est pas le processeur, mais la VRAM (mémoire vidéo).

    Entre le modèle de génération vidéo (MiniMax / diffusion), les modèles de lip-sync haute fidélité (LatentSync) et l’upscaling en 1080p ou 4K, n’importe quelle carte graphique à 8, 12 ou même 16 Go de VRAM sature immédiatement et plante en Out Of Memory.

    j’ai réussi à trouver une NVIDIA GeForce RTX 3090 avec ses 24 Go de GDDR6X pour un excellent prix. Les 24 Go de VRAM sont le véritable “cheat code” du machine learning local :

    • On peut charger de gros checkpoints en mémoire sans quantification agressive.
    • On peut enchaîner le rendu par morceaux (chunking) et le traitement lourd en continu.
    • Le coût marginal d’une vidéo longue devient littéralement 0 € (hors électricité de la maison). Que mon épisode dure 2 minutes ou 20 minutes, je ne paie plus un seul centime d’API vidéo.

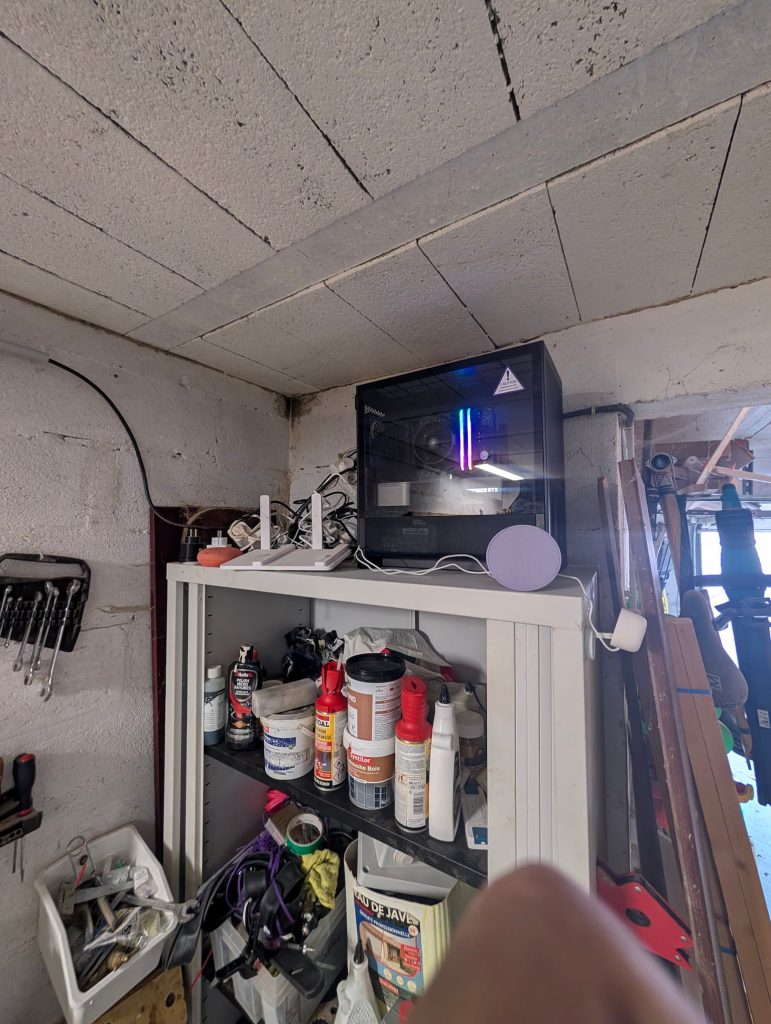
    J’ai monté la carte dans une tour dédiée sous Linux (ubuntu server, qui est pas trop relou pour installer les drivers nvidia) qui tourne tranquillement chez moi.

    Brancher une machine de salon à AWS sans bidouille réseau#

    Avoir la puissance GPU à la maison, c’est bien. Mais comment faire communiquer un orchestrateur Cloud (AWS Step Functions) avec une machine physique posée derrière la box Internet du salon ?

    contraintes strictes :

    1. Zéro port ouvert sur la box : hors de question de faire du port forwarding ou d’exposer une API sur ma connexion résidentielle.
    2. Pas d’IP publique fixe requise : la box peut changer d’IP sans jamais impacter la production.
    3. Zéro coût d’attente sur AWS : le rendu d’une vidéo longue prend du temps (plusieurs dizaines de minutes selon la durée et le nombre de plans). Hors de question d’avoir une Lambda qui tourne dans le vide à attendre la fin du rendu (timeout max de 15 min de toute façon, et facturation à la milliseconde).
    4. Résilience : si le serveur local est éteint ou redémarre, le job ne doit pas être perdu et doit attendre son tour.

    La solution idéale existe nativement dans AWS : le pattern waitForTaskToken de Step Functions, couplé à une file Amazon SQS.


    Le cœur de l’architecture : Le patternwaitForTaskToken#

    Dans AWS Step Functions, vous pouvez appeler un service (ici SQS) en mode asynchrone avec accusé de réception différé grâce à la ressource : arn:aws:states:::sqs:sendMessage.waitForTaskToken.

    Comment ça marche concrètement ?#

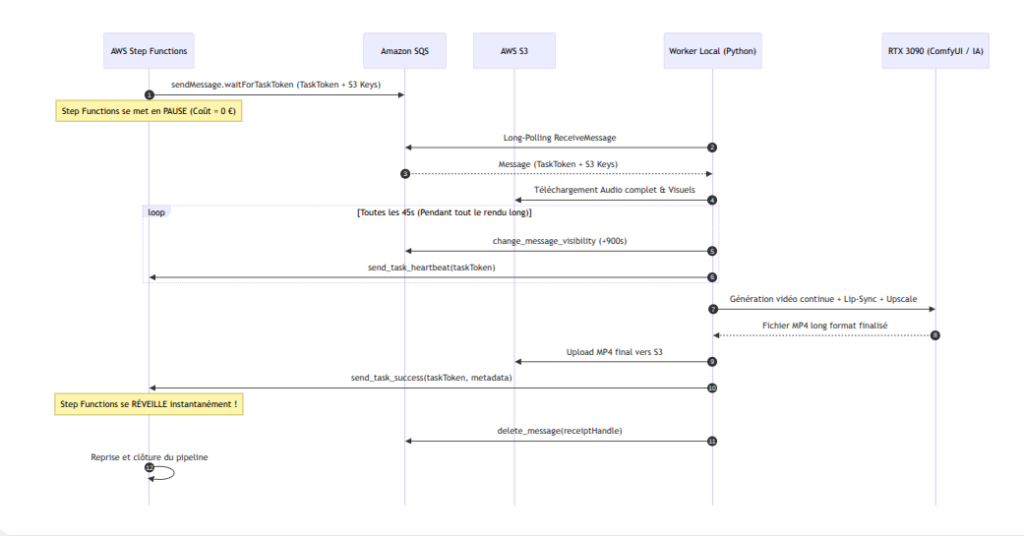
    1. Step Functions dépose un message dans SQS : Dans le corps du message, Step Functions injecte automatiquement une variable d’exécution contextuelle : $$.Task.Token. C’est un jeton chiffré unique représentant l’instance exacte du workflow en cours.
    2. Step Functions se met en PAUSE (Coût = 0 €) : L’exécution s’arrête sur cet état (WaitForLocalWorker). Et c’est là toute la beauté du modèle Step Functions Standard : le temps d’attente ne coûte absolument rien (on ne paie que les transitions d’états, aucune facturation à la durée d’attente !). J’ai configuré un TimeoutSeconds: 7200 (2 heures de marge).
    3. Le Worker local dépile le message (Pull sortant) : Sur mon serveur local, un daemon Python sous systemd effectue du long-polling sortant sur la file SQS (ReceiveMessage avec WaitTimeSeconds=20). Comme c’est la machine locale qui initie la connexion HTTPS vers AWS, aucun port entrant n’est ouvert sur la box.
    4. Maintien de la visibilité SQS & Heartbeats Step Functions : Pendant que la RTX 3090 calcule les différents segments de la vidéo longue, un thread d’arrière-plan (MessageHeartbeatThread) s’exécute en parallèle :
      • Il renouvelle périodiquement le VisibilityTimeout du message SQS (ex: +900s toutes les 45s) pour qu’aucun autre processus ne récupère le message.
      • Il envoie un heartbeat à Step Functions (sfn_client.send_task_heartbeat(taskToken=token)) pour notifier à AWS que le job avance normalement.
    5. Rendu vidéo long & Upload S3 : Le worker télécharge les assets depuis S3 (l’audio complet généré par Gemini TTS, le script, les visuels de référence). Le moteur local génère la vidéo, applique le lip-sync sur toute la durée, fait l’upscale, assemble le MP4 final et le téléverse sur S3.
    6. Le réveil instantané de Step Functions : Dès que le téléversement S3 est terminé, le worker appelle l’API AWS :pythonCopiersfn_client.send_task_success( taskToken=task_token, output=json.dumps({"status": "SUCCESS", "video_s3_key": final_key}) ) Instantanément, Step Functions reprend son exécution dans le Cloud, reçoit la clé de la vidéo générée, et enchaîne sur les étapes finales (publication Spotify / YouTube, notifications, etc.).
    7. Acquittement SQS : Le worker supprime le message de la file SQS. Si la machine venait à crasher ou couper le courant en plein milieu, le token n’est jamais validé et le message redevient disponible dans SQS.

    Schéma de la pipeline actuelle#

    Voici l’architecture complète combinant le Cloud Serverless AWS et le serveur local :

    Comment je sors des vidéos longues sans exploser la VRAM#

    Générer une vidéo de 10 minutes d’un coup dans un modèle de diffusion saturerait n’importe quelle carte graphique. Voici l’astuce côté worker :

    1. Découpage audio & multi-plans : la piste audio est segmentée intelligemment. Le script génère plusieurs plans de caméra (face, léger profil, plan moyen) en réinjectant une image de référence (refimage) pour garantir la cohérence absolue du personnage et de ses vêtements d’un plan à l’autre.
    2. Génération continue & Lip-Sync par chunk : le moteur (MiniMax / ComfyUI) génère les séquences vidéo, puis ByteDance LatentSync 1.6 synchronise les lèvres de l’avatar avec une précision redoutable sur l’audio français.
    3. Upscale & Concaténation FFmpeg : chaque segment passe par un upscale 4x-UltraSharp pour atteindre un rendu 1080p super net, puis FFmpeg assemble l’ensemble de manière transparente avec la piste audio complète.

    La RTX 3090 encaisse le batching tranquillement avec ses 24 Go, sans saturation.


    Bilan financier : La vidéo longue pour 0 €#

    Voici le comparatif concret entre avant et maintenant :

    Poste de coûtApproche Full Cloud (SaaS / EC2)Approche Hybride Actuelle
    Génération Vidéo Longue200 € à 1 000+ € / mois (crédits HeyGen/Runway ou EC2 g5)0 € (Inférence locale sur RTX 3090)
    Orchestration (Step Functions)Élevé si polling ou Lambdas d’attente~0,01 € (Pause gratuite avec TaskToken)
    Queue & Stockage (SQS / S3)Quelques centimes< 0,10 € / mois
    Synthèse & TTS (Gemini)~0,50 € / jour~0,50 € / jour
    Total VidéoHors de prix en side-project0 € de coût API vidéo

    Retours d’expérience#

    • La puissance du pattern taskToken : c’est un game changer. Au lieu de voir le serverless comme une prison dorée où tout doit tourner sur Lambda en moins de 15 minutes, waitForTaskToken permet de transformer n’importe quel serveur ou cluster on-premise en extension naturelle de votre cloud AWS.
    • Résilience totale : si le serveur est éteint la nuit ou redémarre pour une mise à jour système, le message attend sagement dans SQS. Dès que le daemon se lance au boot, il prend le job et réveille Step Functions à la fin.
    • Liberté totale sur les modèles : pas de filtre absurde d’API tierce, pas de compression agressive de bitrate, choix total des checkpoints, des LoRA et des upscalers.

    Le dépôt GitHub est toujours disponible ici : https://github.com/bmallory/podcraft-ai
  • [Side Project Open Source] PodCraft AI : Pipeline serverless pour générer et publier des podcasts thématiques 100% automatisés (Gemini, AWS Lambda/Step Functions, Spotify)

    Voici un side-project sur lequel j’ai travaillé et que j’ai décidé de passer open-source

    L’idée de départ : créer un pipeline autonome capable de transformer automatiquement une veille thématique (flux RSS, articles web) en un véritable épisode de podcast quotidien avec audio studio, publication automatique sur Spotify et génération de contenus courts (Shorts / visuels) pour les réseaux sociaux.

    Le dépôt GitHub est disponible ici : https://github.com/bmallory/podcraft-ai
    Je l’utilise personnellement tous les matins pour générer mon propre flash d’info quotidien : L’Actu Quotidienne sur Spotify https://open.spotify.com/show/033o6fFRVxpBRhRgGsCxDz?si=2a9e259eec7f4ca6

    A la base, je pensais que le résultat serait une simple « revue de presse » linéaire qui lirait les résumés les uns après les autres. Mais en affinant le prompt, j’ai remarqué un truc vraiment intéressant : le LLM croise intelligemment les différentes sources traitant du même sujet.

    Il arrive ainsi à enrichir un fait d’actualité rapporté par un média avec des chiffres, des explications de fond ou des citations provenant d’un autre site. Au final, il y a une légère valeur ajoutée et une synthèse plus digeste que si je consultais manuellement 5 ou 6 sites d’actualités au réveil.

    Le projet tourne sur une architecture Serverless orchestrée sur AWS :

    • Synthèse & Scripting : Google Gemini 3.7 Flash pour analyser les sources, synthétiser l’actualité et rédiger un script fluide adapté à l’oral (sans métadonnées superflues).

    • Synthèse Vocale (TTS) : Gemini 3.1 Flash TTS Preview (voix multi-modales haute fidélité) générant du flux audio PCM brut 24kHz.

    • Traitement Média sur AWS Lambda : Fonctions Lambda packagées en conteneurs Docker (Python 3.12) embarquant un binaire statique FFmpeg pour convertir le PCM en MP3 128k et assembler les flux vidéo.

    • Publication Spotify Automatisée : Intégration du CLI officiel save-to-spotify en environnement stateless Lambda, avec restitution des jetons d’authentification DPoP chiffrés depuis AWS Secrets Manager.

    • Orchestration : AWS Step Functions pour coordonner le workflow en parallèle (publication Spotify d’un côté, génération des Shorts et des visuels de l’autre).

    • Visuels & Vidéos courtes : Génération d’illustrations carrées via Imagen 3 et déclinaisons vidéo verticales (Google Veo / HeyGen) pour TikTok et YouTube Shorts.

    Perso je kiffe le serverless: pas a s’emmerder a gerer les ressources, ca s’autoscale a 0 et pour des petits trucs comme ca c’est en dessous des seuils de l’offre gratuite aws. mon coût principal est les tokens Gemini (0,5€/jour en moy.)

  • du code et de l’ia

    Le retour du projet du weekend !
    il y a deux projets que j’ai enfin pu mener a bien avec l’aide de l’IA et notamment la methode BMAD.

    Le premier : le projet argent (aka le coach sportif ).

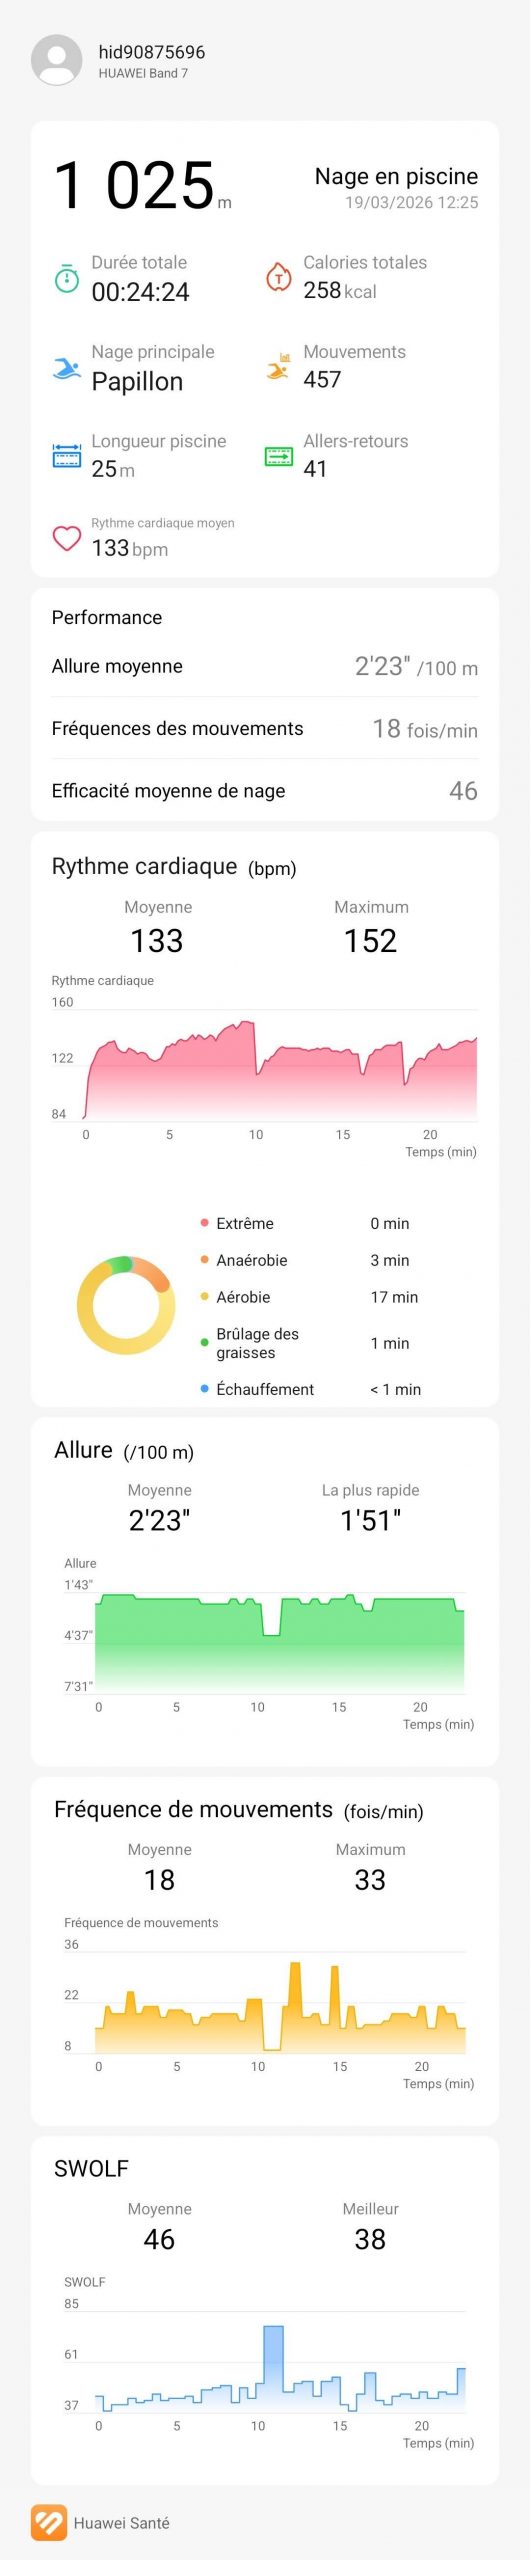
    ca répond a un truc que je fait régulièrement apres la piscine ou le velo : j’ai plein de stats strava / Garmin ou Huawei Santé, mais je ne sais pas les interpreter. Je ne sais pas si c’est une bonne séance ou une mauvaise séance et quoi faire pour la suite.

    Et du coup j’avais pris l’habitude de screenshoter les stats et les balancer a Gemini pour faire une analyse, qui est plutot pas mal, et surtout qu’on peut lire et écouter durant le trajet du retour pour avoir le feedback tout de suite


    et donc le projet Argent fait ca : c’est une app web (en PWA comme ca on peut l’installer sur son tel et ca apparait directement dans les actions de partage d’image sur le tel), sur lequel on dépose et on analyse et on fait un rendu avec du TTS que l’on peut écouter. avec une fonction partage et historique.

    pour la stack technique, j’ai l’habitude de faire tout en serverless et je connais bien sst.dev. c’est donc un projet typique SST.dev :

    • NextJs
    • dynamodb
    • s3
    •  avec des appels api vers la suite Google pour l’ia (Gemini)
    • cloudfront
    • stripe pour le paiement

    avantage : ca coute pas cher (voir 0 quand il n’y a personne dessus (serverless powa)), ca s’autoscale automatiquement avec les memes limites que AWS Lambda : jusqu’a 1000 instances simultanées.


    ce qui est marrant c’est que j’ai écrit genre 10% du code présent dans ce projet. Le reste c’est Google Antigravity qui l’a fait. C’est un peu terrifiant mais c’est aussi très cool : la barrière a l’entrée est tellement basse maintenant que l’on peut POC-er ou meme aller jusqu’a la prod des idées ou des apps auquelles on pense juste de temps en temps en se disant qu’on aura jamais le temps de tester ou de mettre en place.

    là le code est fonctionnel a 100%, il y pas mal de polish a faire mais le core product est là


    le second projet : l’actu quotidienne

    en gros : des pipelines 100% serverless qui scrapent les sites de news et fait un résumé quotidien sous la forme d’un podcast : ( pareil c’est des lambdas, des steps functions et du gemini )

    ce projet est plus pour mon utilitée personnelle mais j’ai noté des trucs marrants dans le contenu généré :

    les sites de news abordent les mêmes sujets (en ce moment le blocage du détroit d’Ormuz). le résumé généré prend des infos d’un site (genre le figaro), et le recroise et donne l’explication avec le contenu d’un autre site (genre liberation). Je ne m’attendais pas a ça et en fait ca fait une information plus complète et peut etre plus neutre que s’il on allait directement sur notre site de news habituel… c’est assez marrant

    et donc pour promouvoir ce truc, j’ai aussi des pipelines de génération de shorts que je poste automatiquement sur tiktok : https://tiktok.com/@lactuquotidienne7/video/7639260019816516896

  • le petit projet du weekend numero 2

    reprise du blog, apres un long moment (il s’est passé plein de trucs) juste pour dire que j’ai désormais un cadre photo e-ink couleur très cool

    l’ecran est tres chouette et il s’intègre super bien avec un cadre Ikea. c’est controllé par un rapsberry pi Zero wifi. il y aurait possibilité de rajouter une batterie pour avoir un truc vraiment sans fil mais finalement a moins d’avoir une grosse batterie, les solutions que j’ai vu a base de 18650 n’offrent que quelques heures d’autonomie.

    du coup je débranche, et comme c’est de l’e-ink ca reste comme ca

  • Le petit projet du weekend

    C’est pas un truc super technique mais c’est sympa quand tout fonctionne plus ou moins du premier coup. Et puis ça m’a permis d’utiliser un peu Fusion360 qui est finalement plutot chouette pour designer ses pièces en 3D.

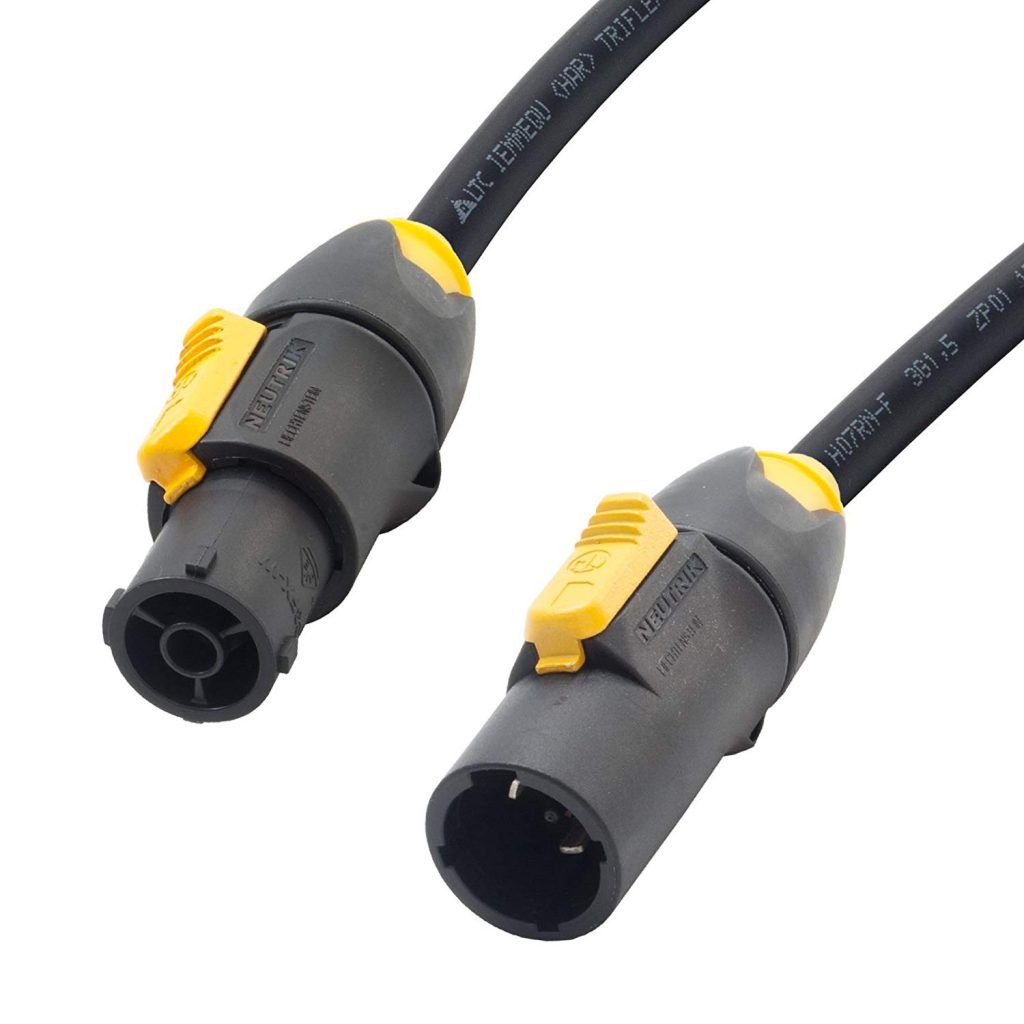
    Le problème: j’ai plein d’outil électro-portatifs avec chacun leur cordon qui prend de la place et qu’il faut brancher/débrancher et qui n’arrêtent pas de se débrancher si on tire dessus. Je suis tombé sur une vidéo qui propose de remplacer les cordons par des prises Neutrik powerCon. Le truc c’est que le type dans la vidéo utilise des prises achetées spécifiquement pour ça.

    prise neutrik powerCon

    Moi il me restait quelques prises de ce type que j’ai utilisé pour mon vélo électrique. Mais une des fiches est en fait prévue pour être montée sur un mur ou un panneau, et pas attachée à un autre câble :

    Du coup j’ai fait un peu de fusion 360 pour modéliser un cache, que j’ai ensuite imprimé en 3D

    une fois que j’avais mon cache, je l’ai tout de même enroulé dans du scotch électrique (faute de pas avoir de gaine thermo de la bonne taille) et j’ai ensuite coupé tous les câbles de mes outils.

    finalement, ça marche tellement bien (surtout le système de verrouillage) que je me demande si je vais pas aussi le mettre sur la tondeuse électrique dont le câble a tendance a se débrancher

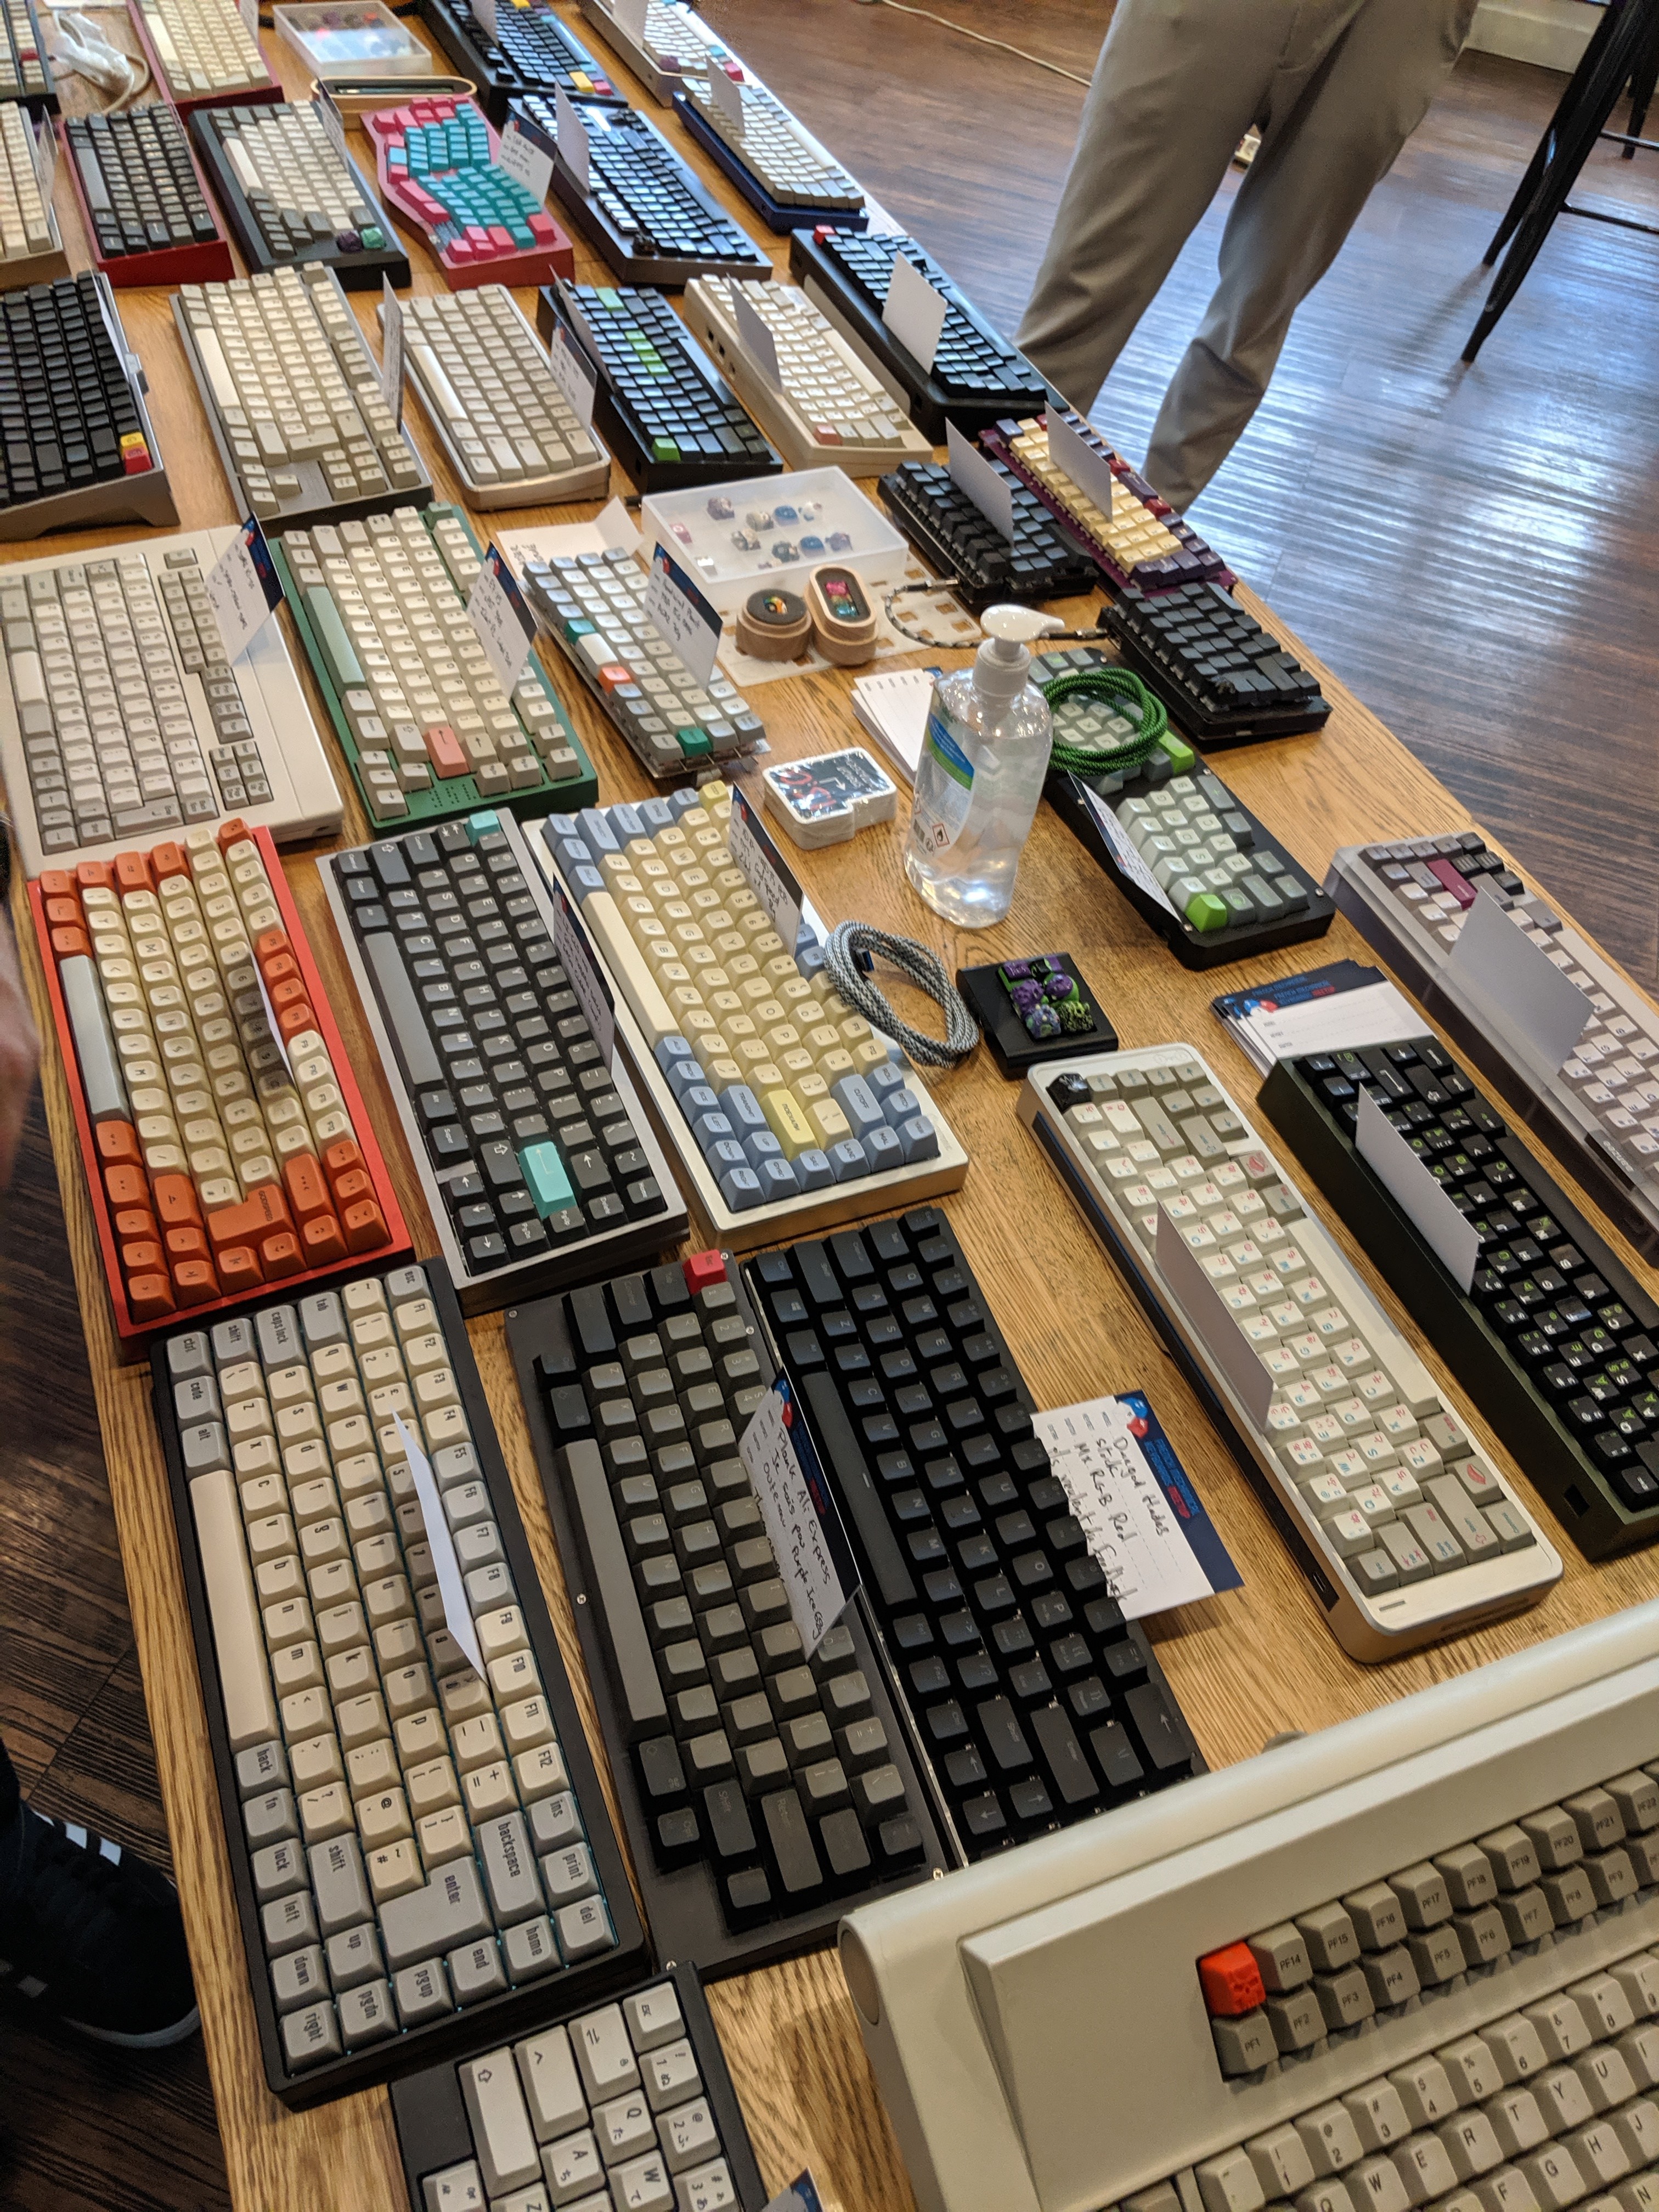
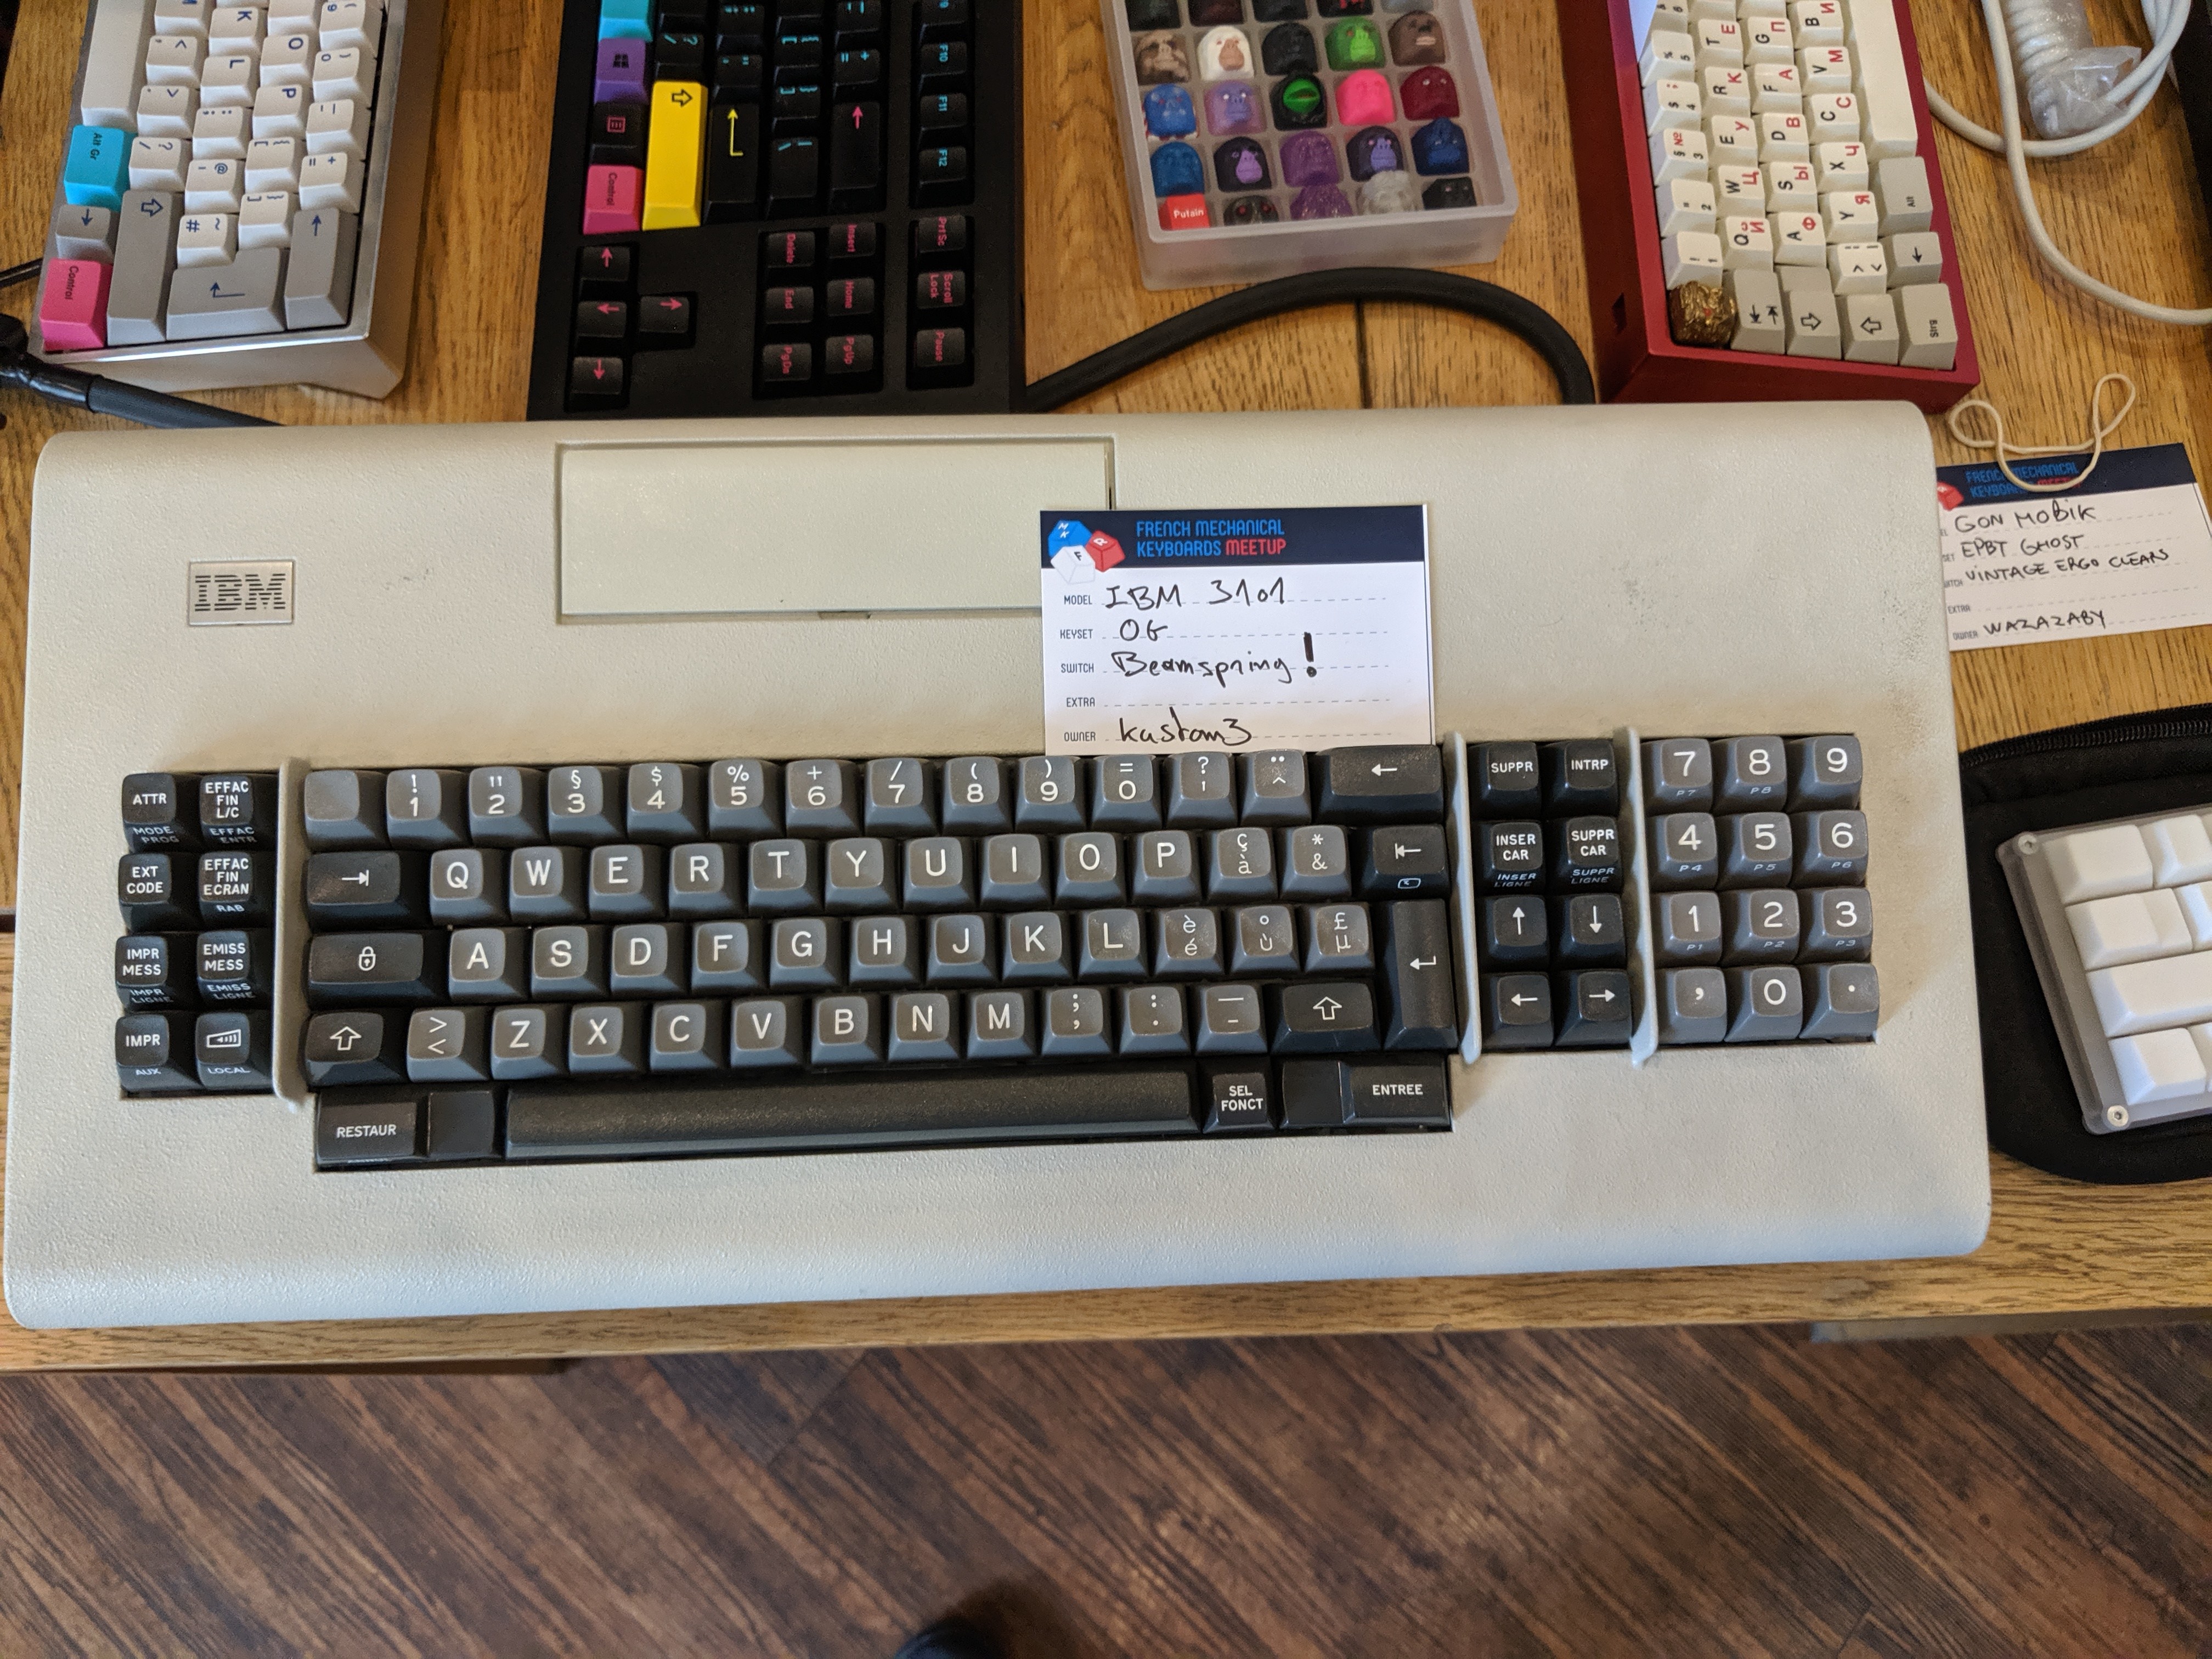
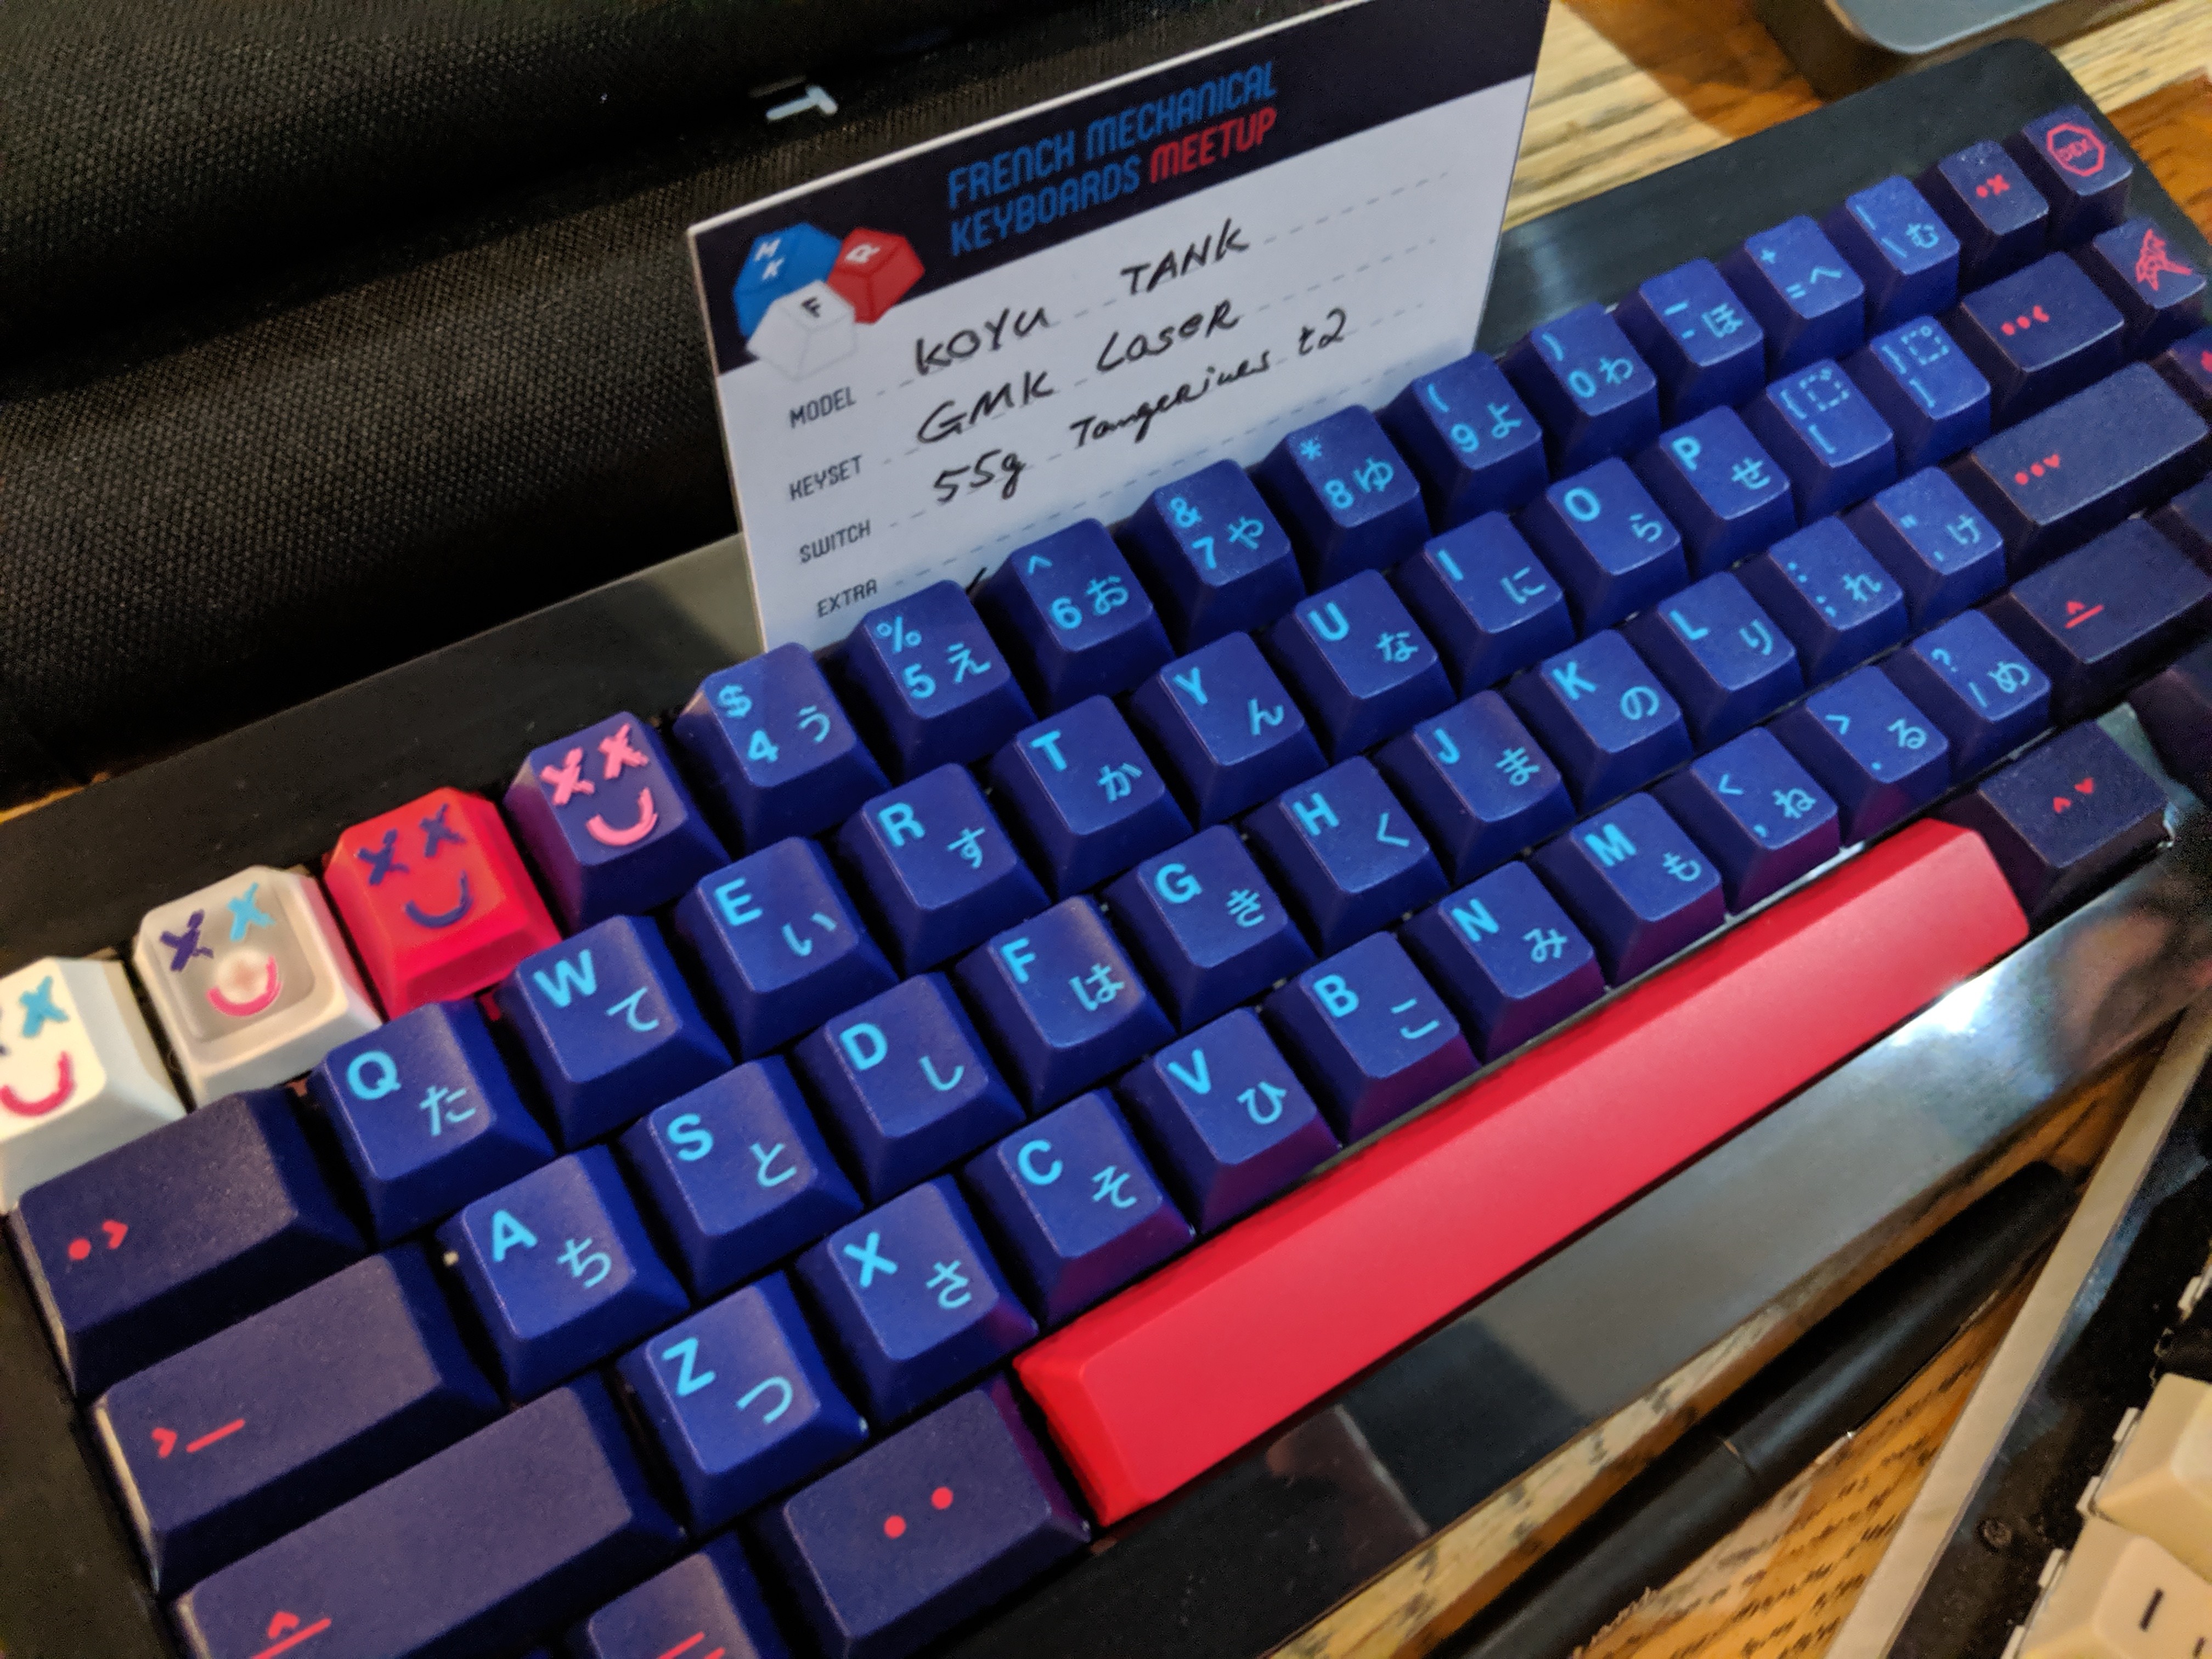
  • Meetup mech keyboard

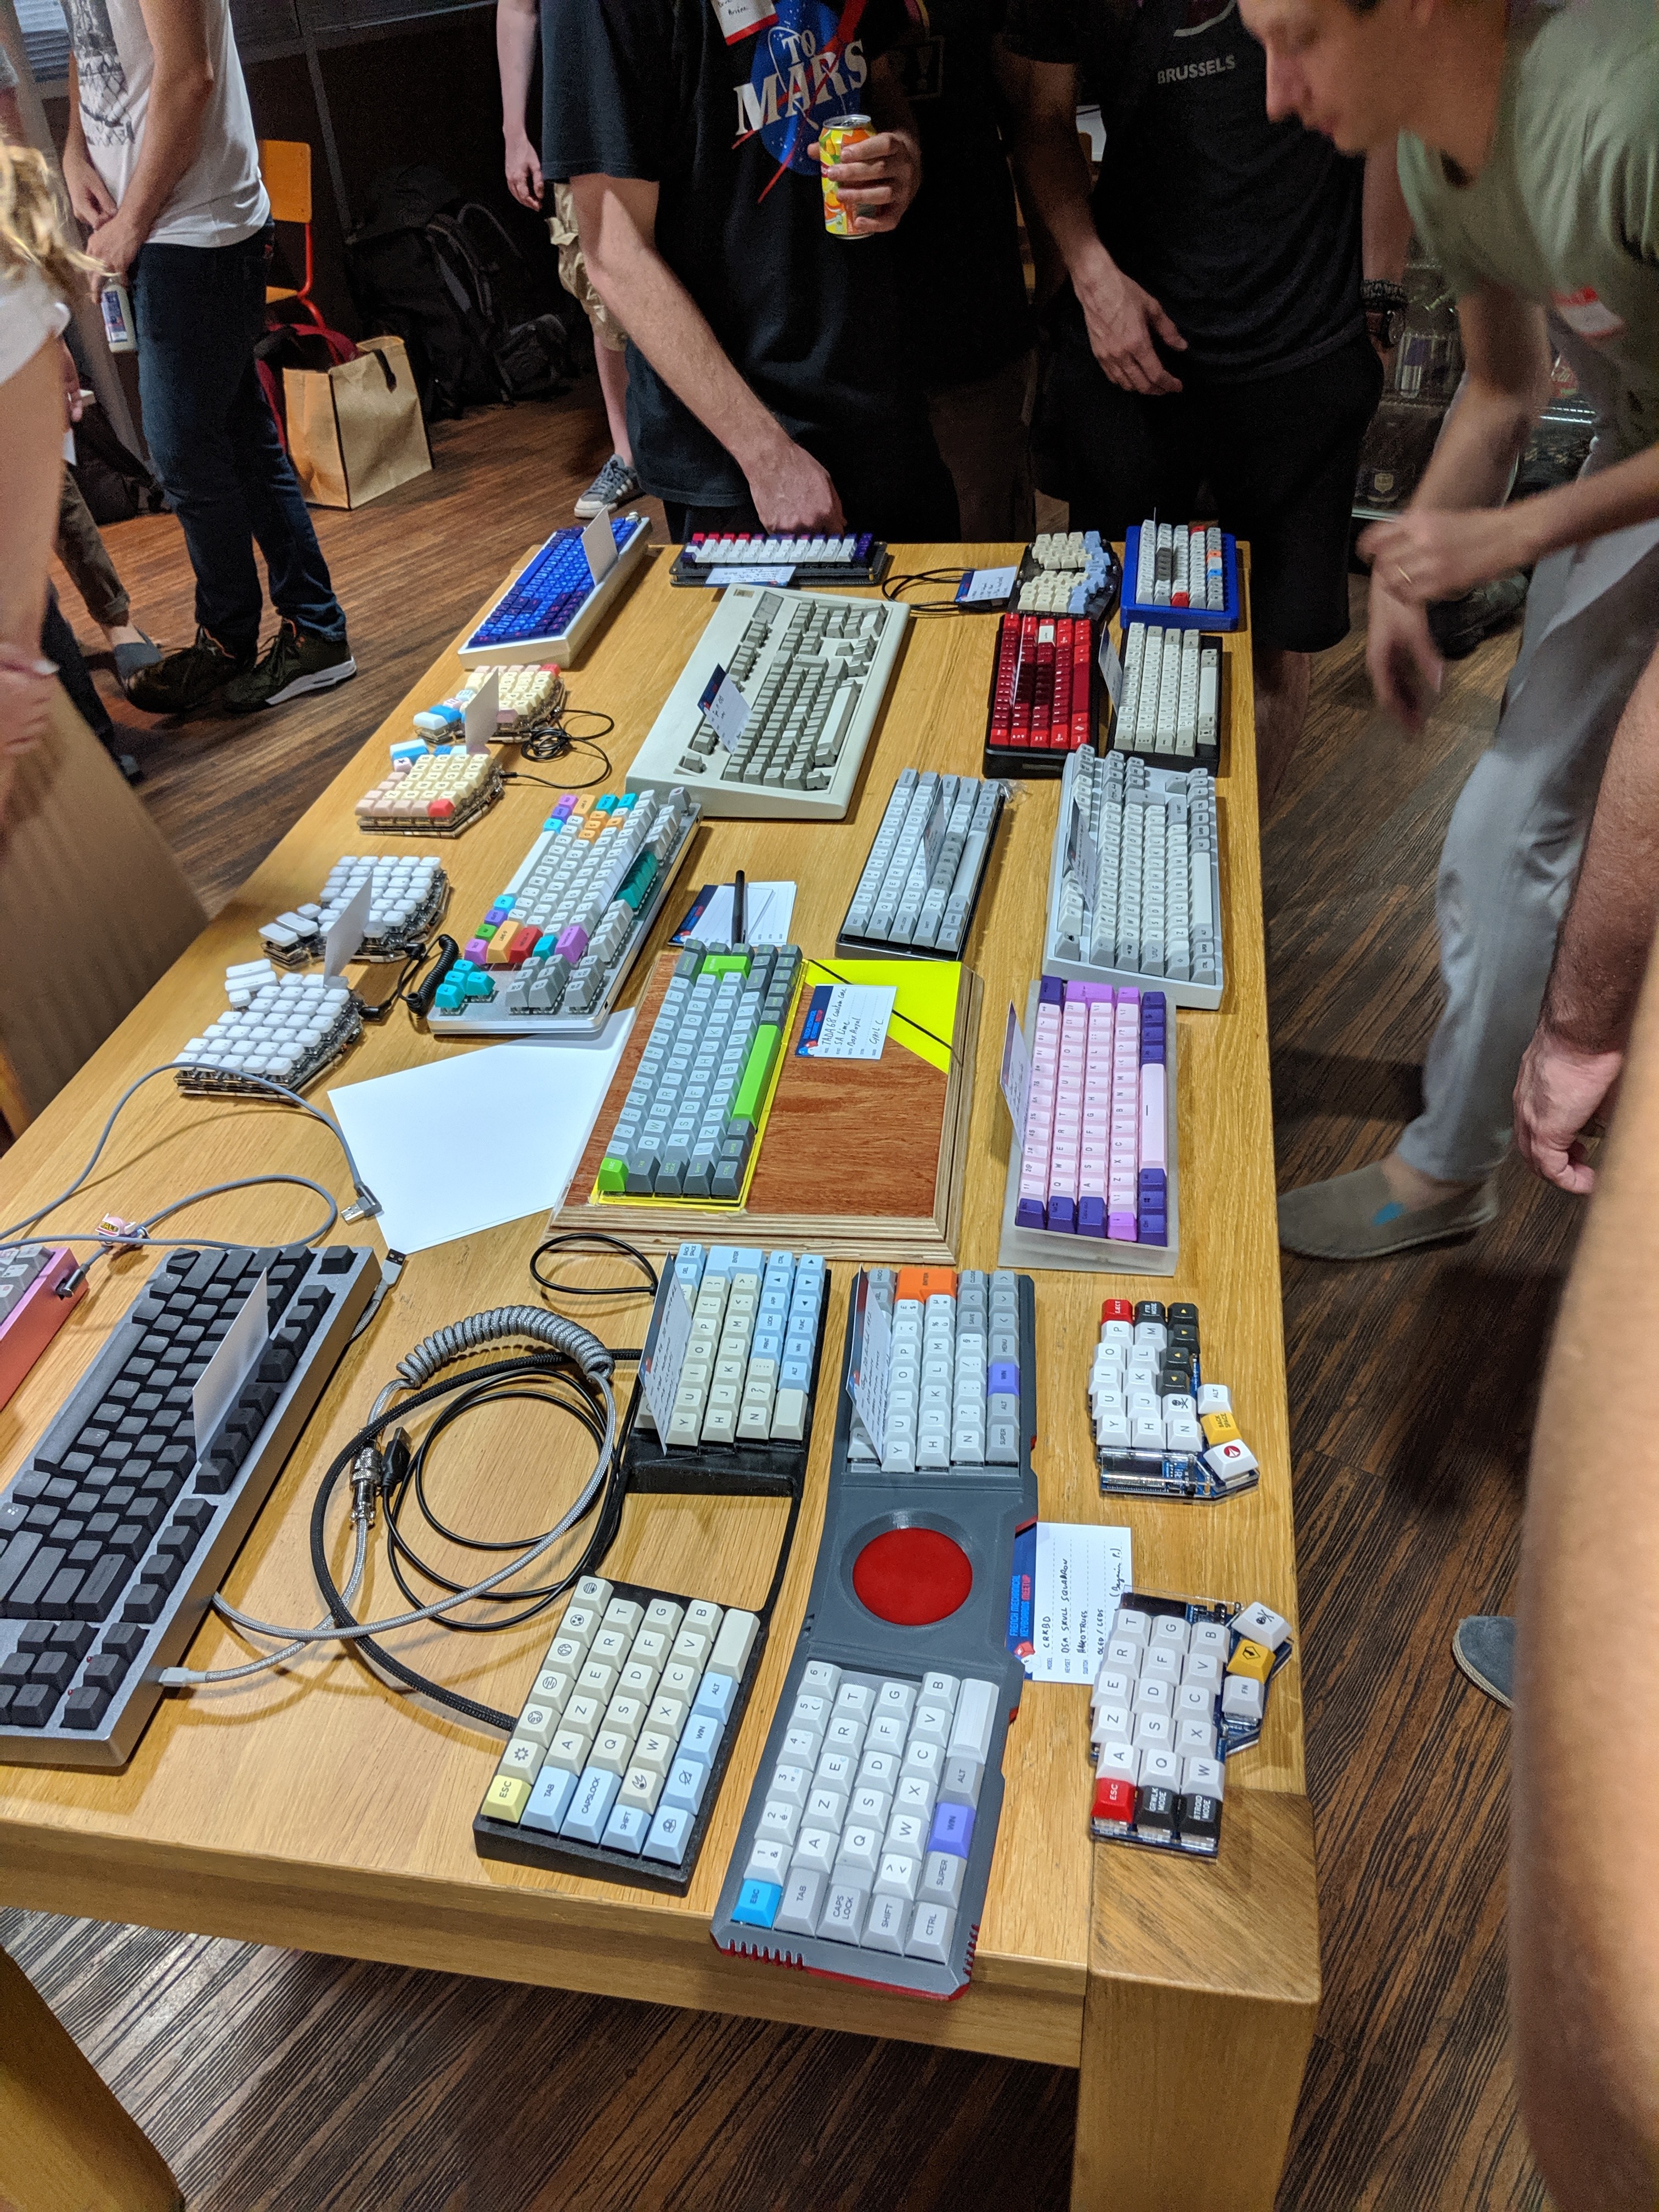
    En août dernier je suis allé à un Meetup d’amateurs de claviers dans les locaux de gandi

  • Je fabrique toujours des claviers

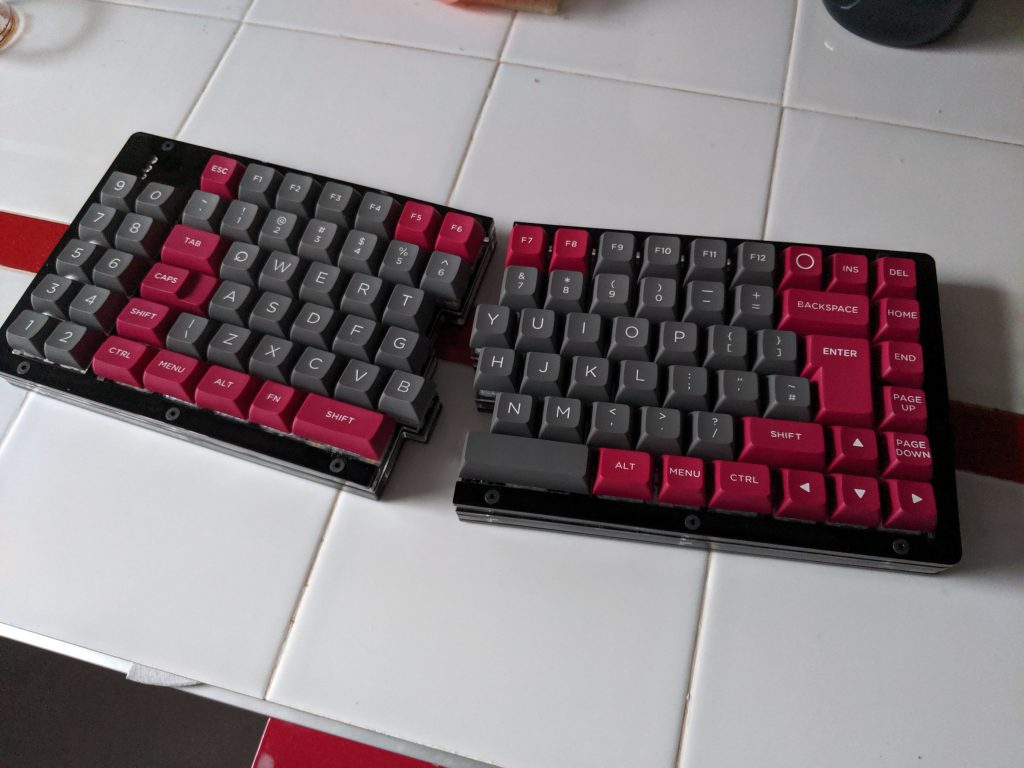
    je suis en train de faire un repose-poignets pour un clavier split qui m’a l’air pas trop mal. Le but ici est de reproduire un peu l’ergonomie que j’avais avec le microsoft sculpt ergonomic (ils en ont d’ailleurs sorti un nouveau pour 2020).

    un clone chinois de VE.A sous bootmapper client. J’ai déssoudé les switchs de base et remplacé avec d’autres plus silencieux et plus tactiles (Zilents V2)

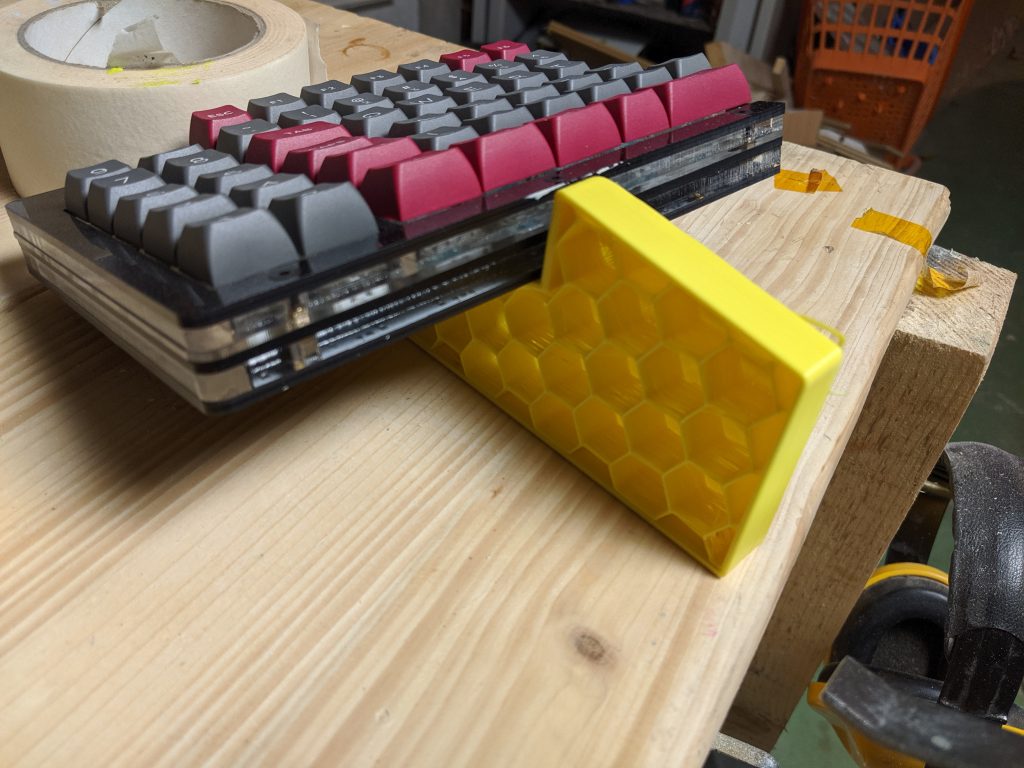
    J’ai modelisé un truc rapidement sous Fusion 360 et imprimé juste une partie pour voir si le profil était correct

    l’inclinaison du clavier est un peu trop forte et les bords sont trop droits

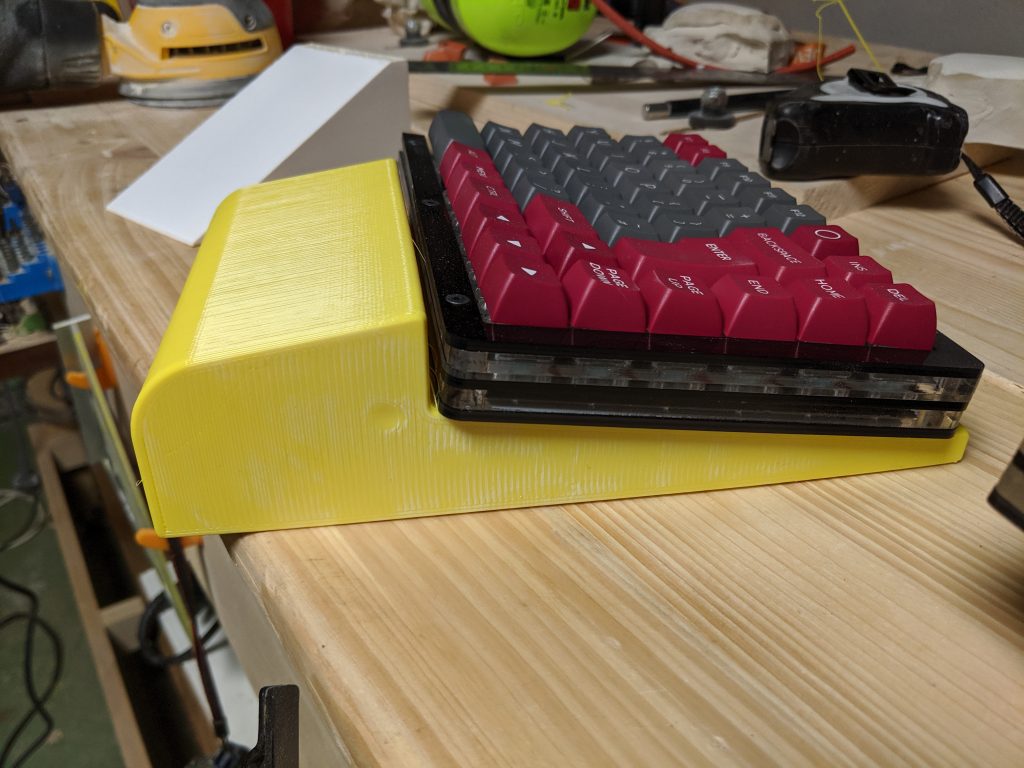
    J’ai ensuite modifié un peu le profil pour avoir quelque chose d’un peu moins haut et avec des bords plus doux

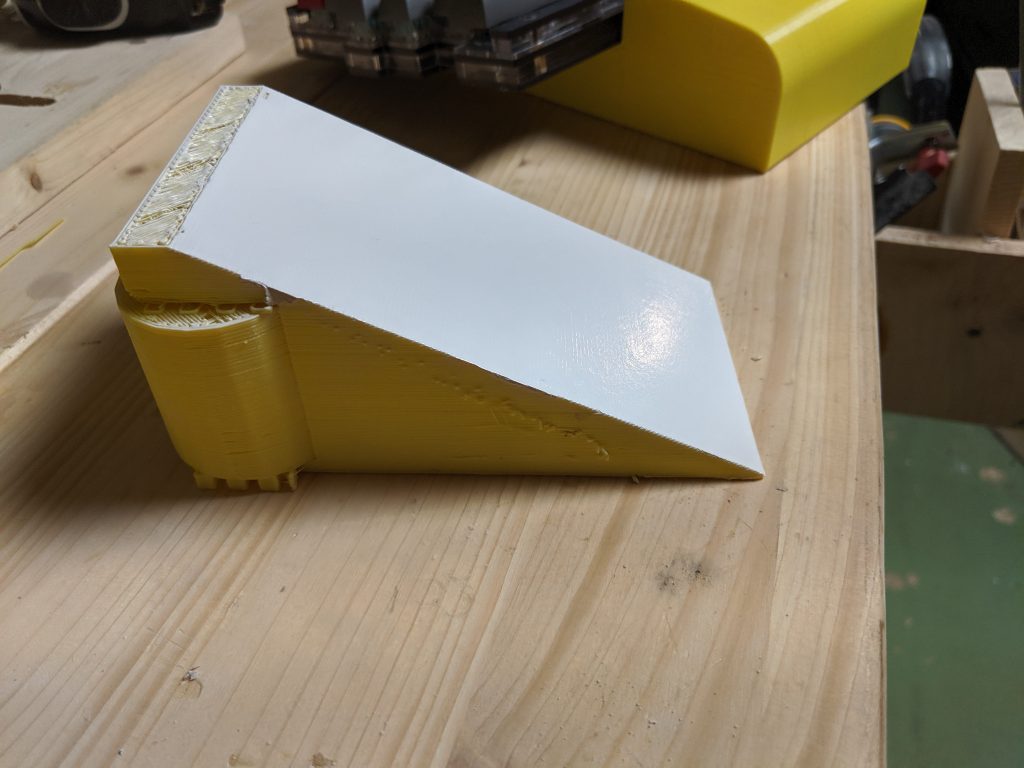
    J’ai également tenté de voir comment on peu supprimer l’aspect “impression 3D”. voici un test en mettant de la pate a bois (j’aurais pu prendre du mastic carrosserie aussi… j’ai fait avec ce que j’avais sous la main) et une couche de peinture blanche en bombe :

    de loin ça rend pas mal mais de près on peu toujours voire un peu l’effet “escalier”. Je suppose qu’avec plusieurs couches et/ou en ponçant un peu moins fort, on peu retrouver un truc lisse.

    note à part : c’est imprimé en PETG. Et je déteste, on a les inconvénients du PLA (ça se ponce pas bien) et les inconvénients de l’ABS (ça s’imprime a haute température). J’ai commandé de l’ABS pour la suite: ça sent mauvais a l’impression mais au moins il est possible en ponçant d’avoir un truc complètement lisse.

    Le but ensuite est de faire un moule en silicone de ce repose poignet, afin ensuite de pouvoir le couler en résine epoxy. Comme ca j’aurais quelque chose ayant un peu plus de poids, et sur lequel je pourrais mettre des vis.

    A suivre…

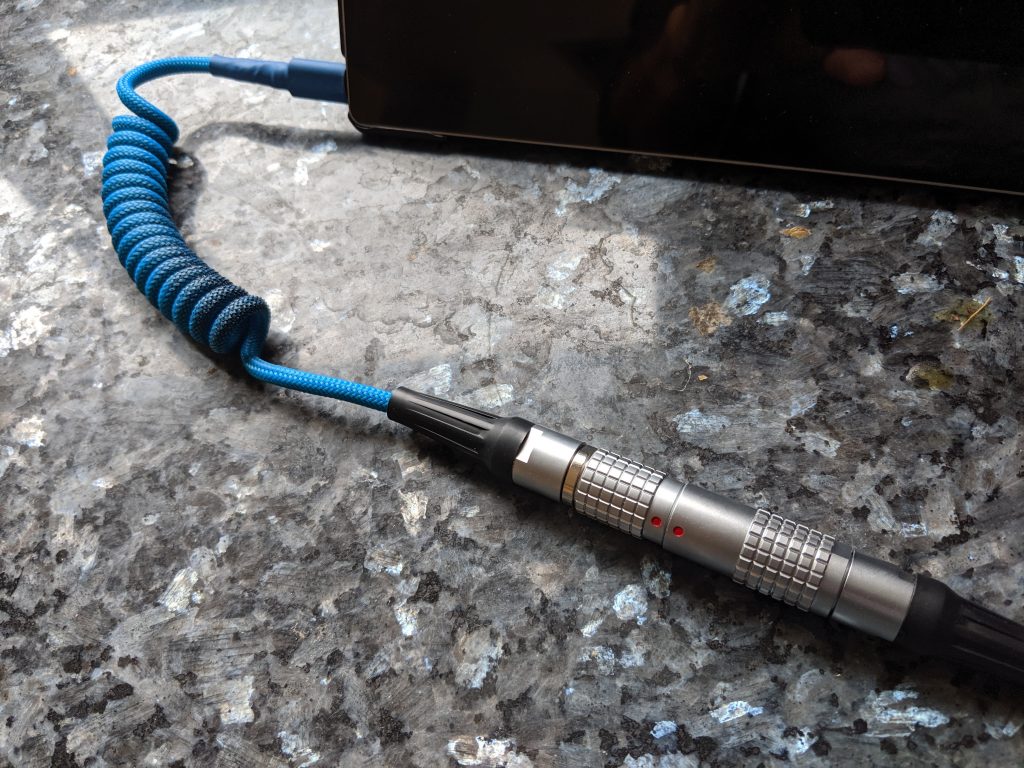
    ah oui, aussi je me suis fait un câble USB avec des connecteurs LEMO juste pour la classe

  • Prochaines sorties netflix

    Développement d’une app proposant de lister les dernieres sorties netflix sur les assistants Google.

    Juste histoire de voir comment google cloud platform fonctionne, je suis en train de dev une action Google Assistant qui répond à un de mes problèmes : “qu’est-ce qu’il y a de nouveau sur Netflix aujourd’hui ?“.
    J’ai choisi GCP car je bouffe pas mal d’AWS au boulot et j’aimerais bien voir ce à quoi ressemble la concurrence. Idem, je dev en python principalement pour me changer du PHP (il y a donc des chances qu’il y ai du code pas beau du tout dans ces pages).

    Etape 1 : création d’une app serverless qui chope les dernières sorties Netflix

    en regardant rapidement j’ai trouvé ceci : https://www.justwatch.com/ qui dispose d’une API qui liste, entre autres, les sorties netflix.

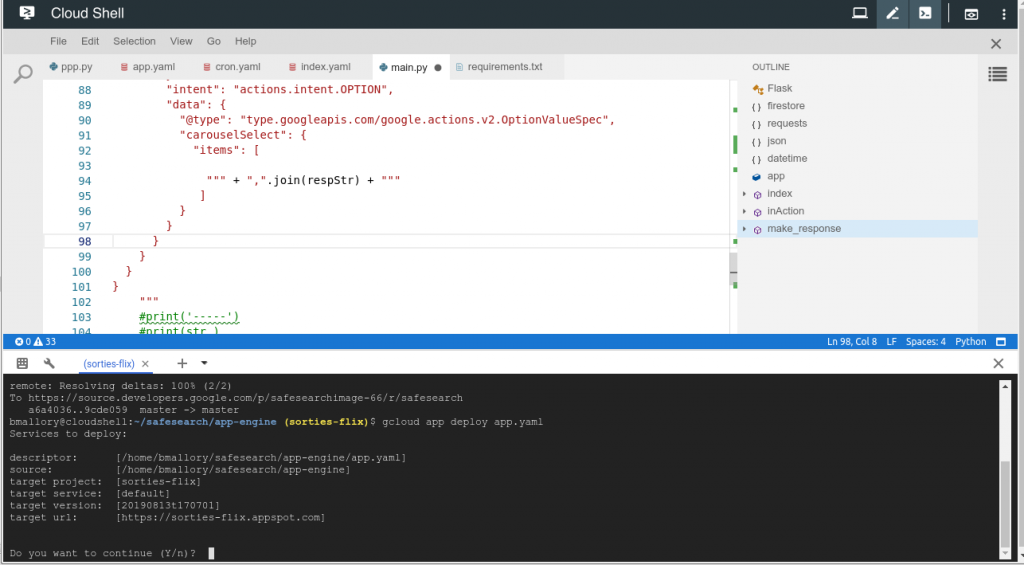
    l’environnement de dev sur GCP est pas trop mal pour qui ne veut pas installer plein de trucs. Google met à disposition une petite machine et un éditeur ainsi que tout ce qu’il faut pour se créer son environnement, le tout dans un navigateur

    l’environnement de dev de GCP

    on a juste a écrire son code python, remplir son app.yaml et l’envoyer dans le compute engine de google.

    Stockage des données : Firestore + bucket public

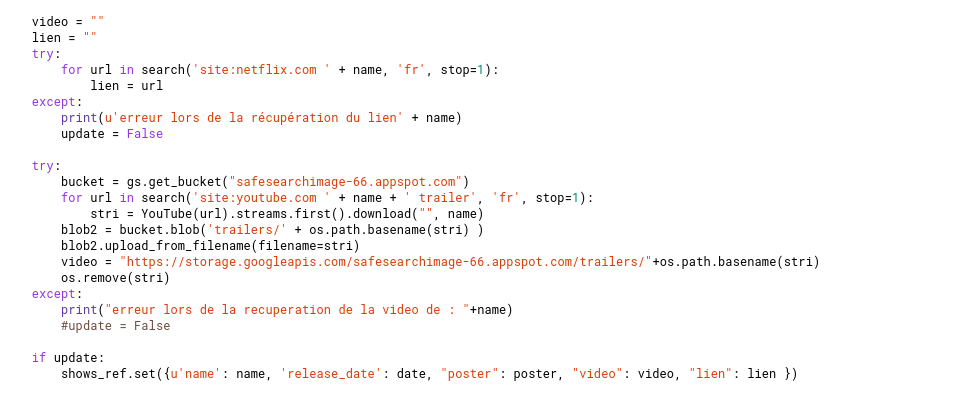
    j’ai donc fait un petit script lancé tous les jours qui interroge une API pour connaître les dernières sorties, puis prend le premier résultat Google sur une requête “site:netflix.com [nom série] ” afin de récupérer le lien de la série ou film sur netflix, puis je fais la même chose pour youtube afin de récupérer le trailer.

    le cron d’indexation

    on balance ensuite tout dans un bucket pour les trailers, et dans Firestore pour les données

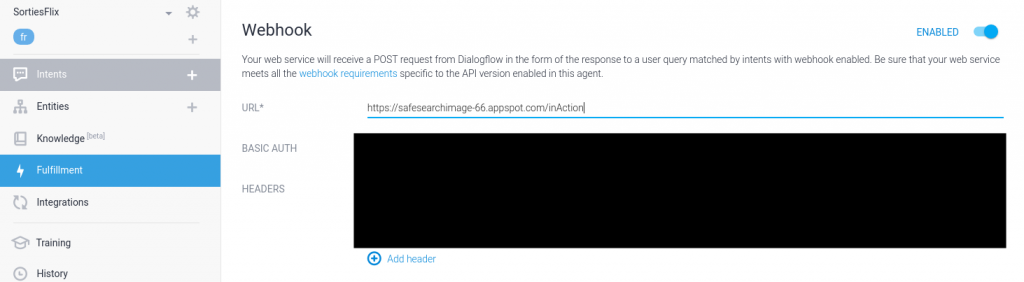
    J’ai ensuite créé une “action” Google Assistant qui liste les 10 dernières entrées de cette base. La partie dialogflow est assez simple, le seul truc intéressant est la partie où l’on dit d’interroger une url spécifique pour répondre à la demande

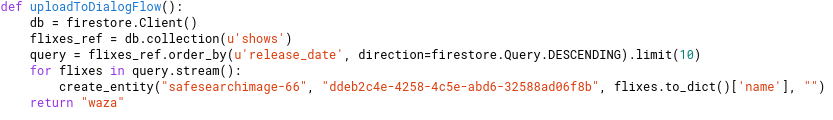
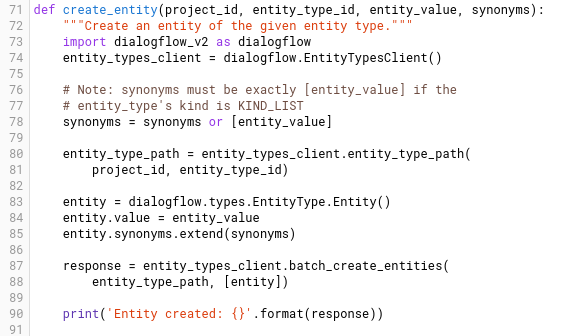
    ainsi que le cron d’ajout d’entité a dialogflow afin qu’il puisse reconnaître les différents film et séries au fur et a mesure que l’on alimente la base de données

    J’ai essayé d’afficher de la vidéo dans Google Assistant, mais je n’ai pas trouvé comment. Au jour d’aujourd’hui, je ne fait que balancer l’image et un lien vers Netflix, alors que je m’embête à récupérer le trailer. J’utilise les rich responses de Google. Ca reste assez limité, on ne peut donner qu’un seul lien web sortant et cela ne marchera que sur les téléphones. J’aurais bien aimé afficher le trailer dans le cas de device avec écran mais si on a bien un truc prévu pour lire de l’audio :

    on n’a rien pour de la vidéo. Je ne suis même pas sûr que l’on puisse interlinker pour renvoyer sur youtube par exemple.

    Bref c’était marrant, a l’utilisation je trouve le truc un peu plus intuitif qu’AWS. notamment au niveau de l’interconnexion entre les différents services (stockage, bdd, assistant, etc.)

    le skill L’action est visible là : https://assistant.google.com/services/a/uid/000000e9d213c0d3

    ou bien sur n’importe quel Google Assistant en disant “ok Google, parler avec Dernières sorties Netflix”

  • Qulbix : almost done!

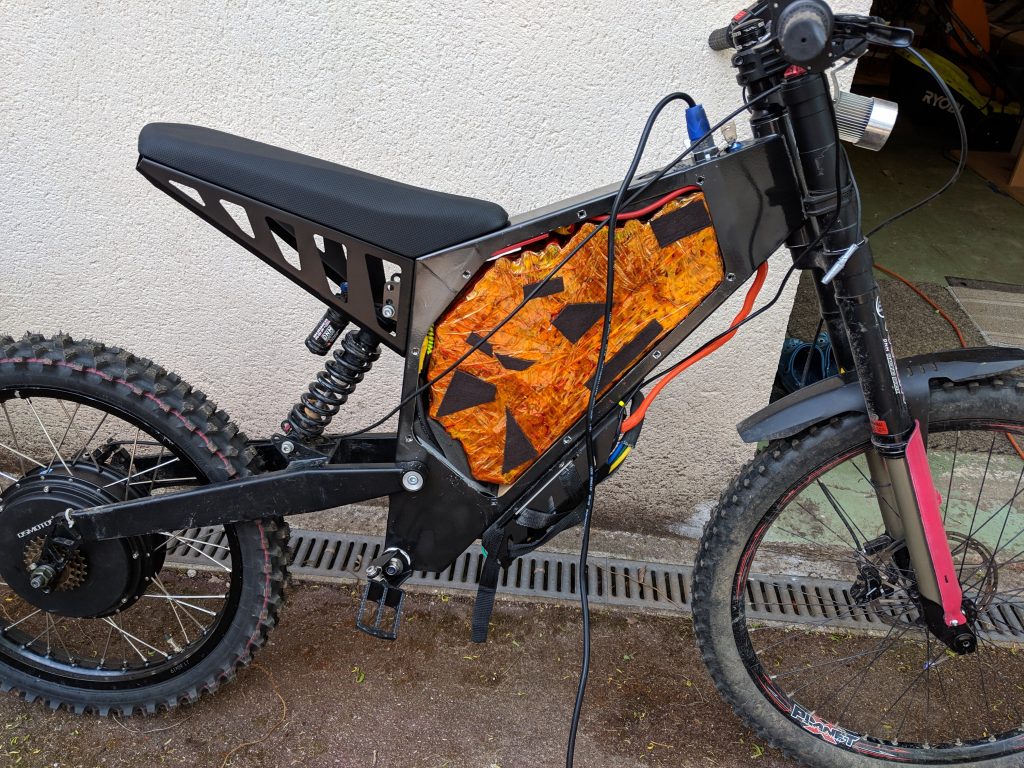
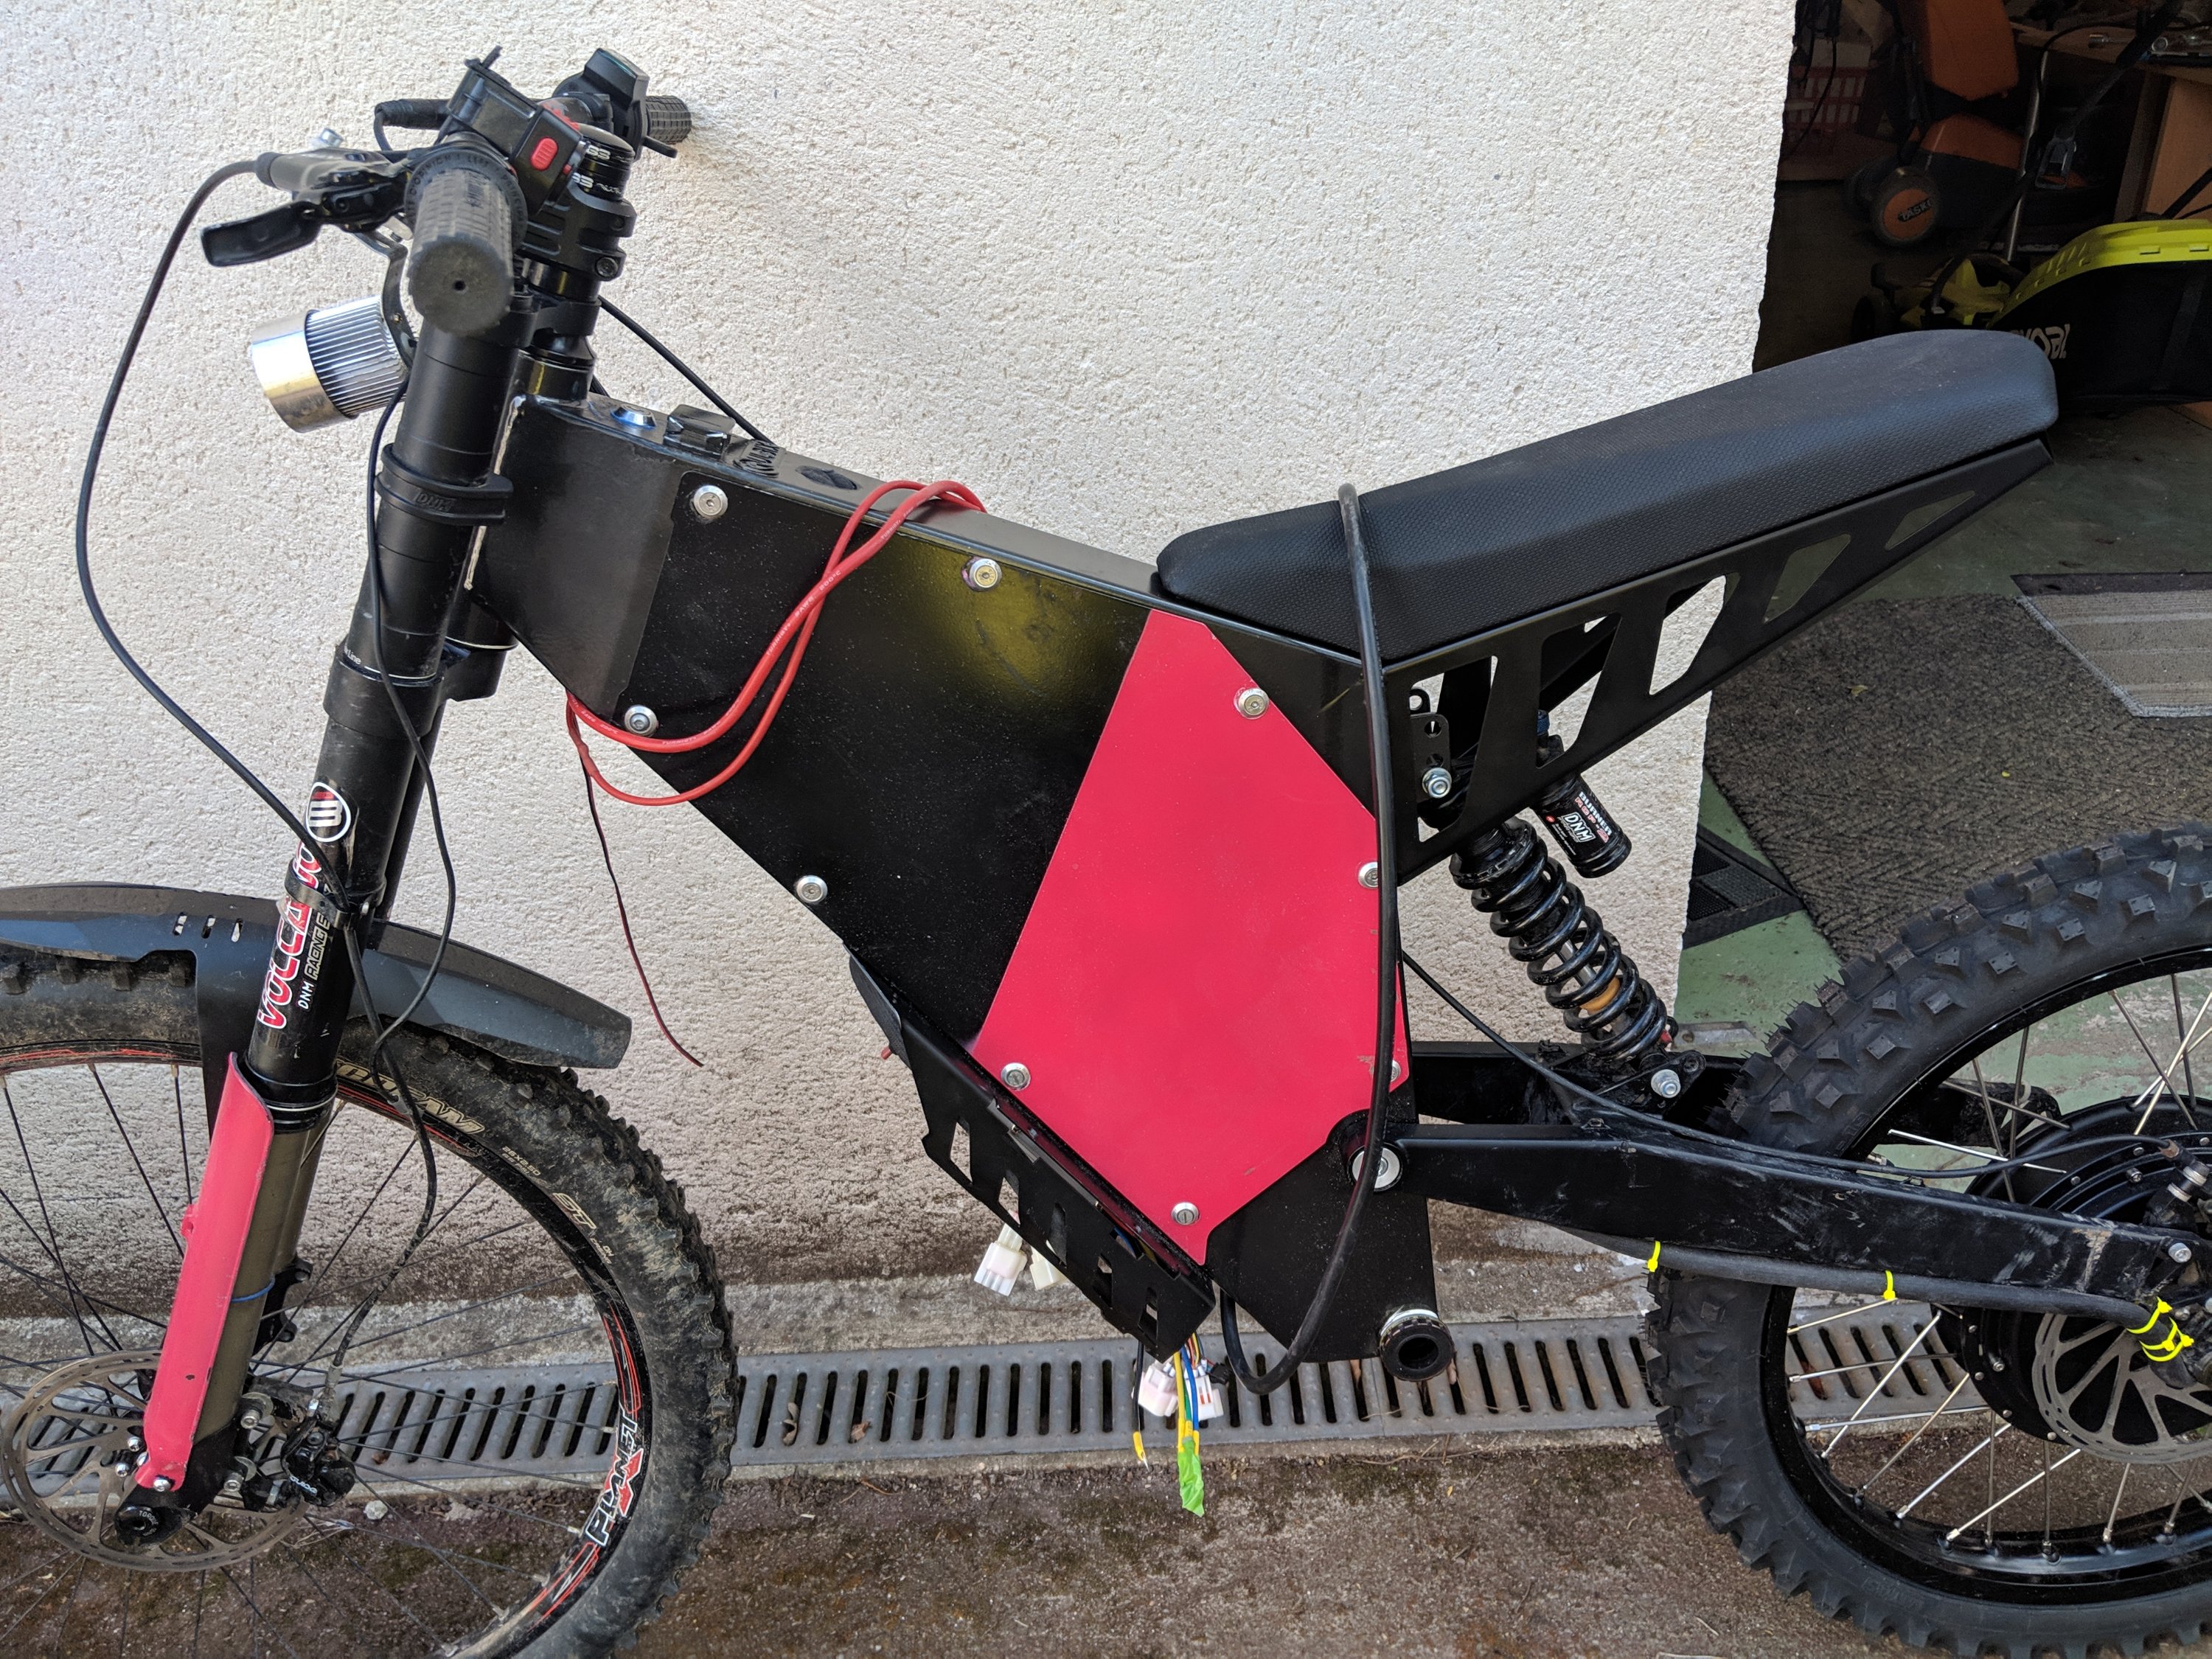
    J’ai enfin assez avancé pour faire un test sur route. Verdict : ça trace ! Je pensais avoir sous évalué le contrôleur de vitesse, un kls7212s avec 50A en continu, boost 120A sur 20secondes a 72v. Upgradé depuis a un nucular 12f 100A continu avec un boost a 200A ou 300A, je ne sais plus

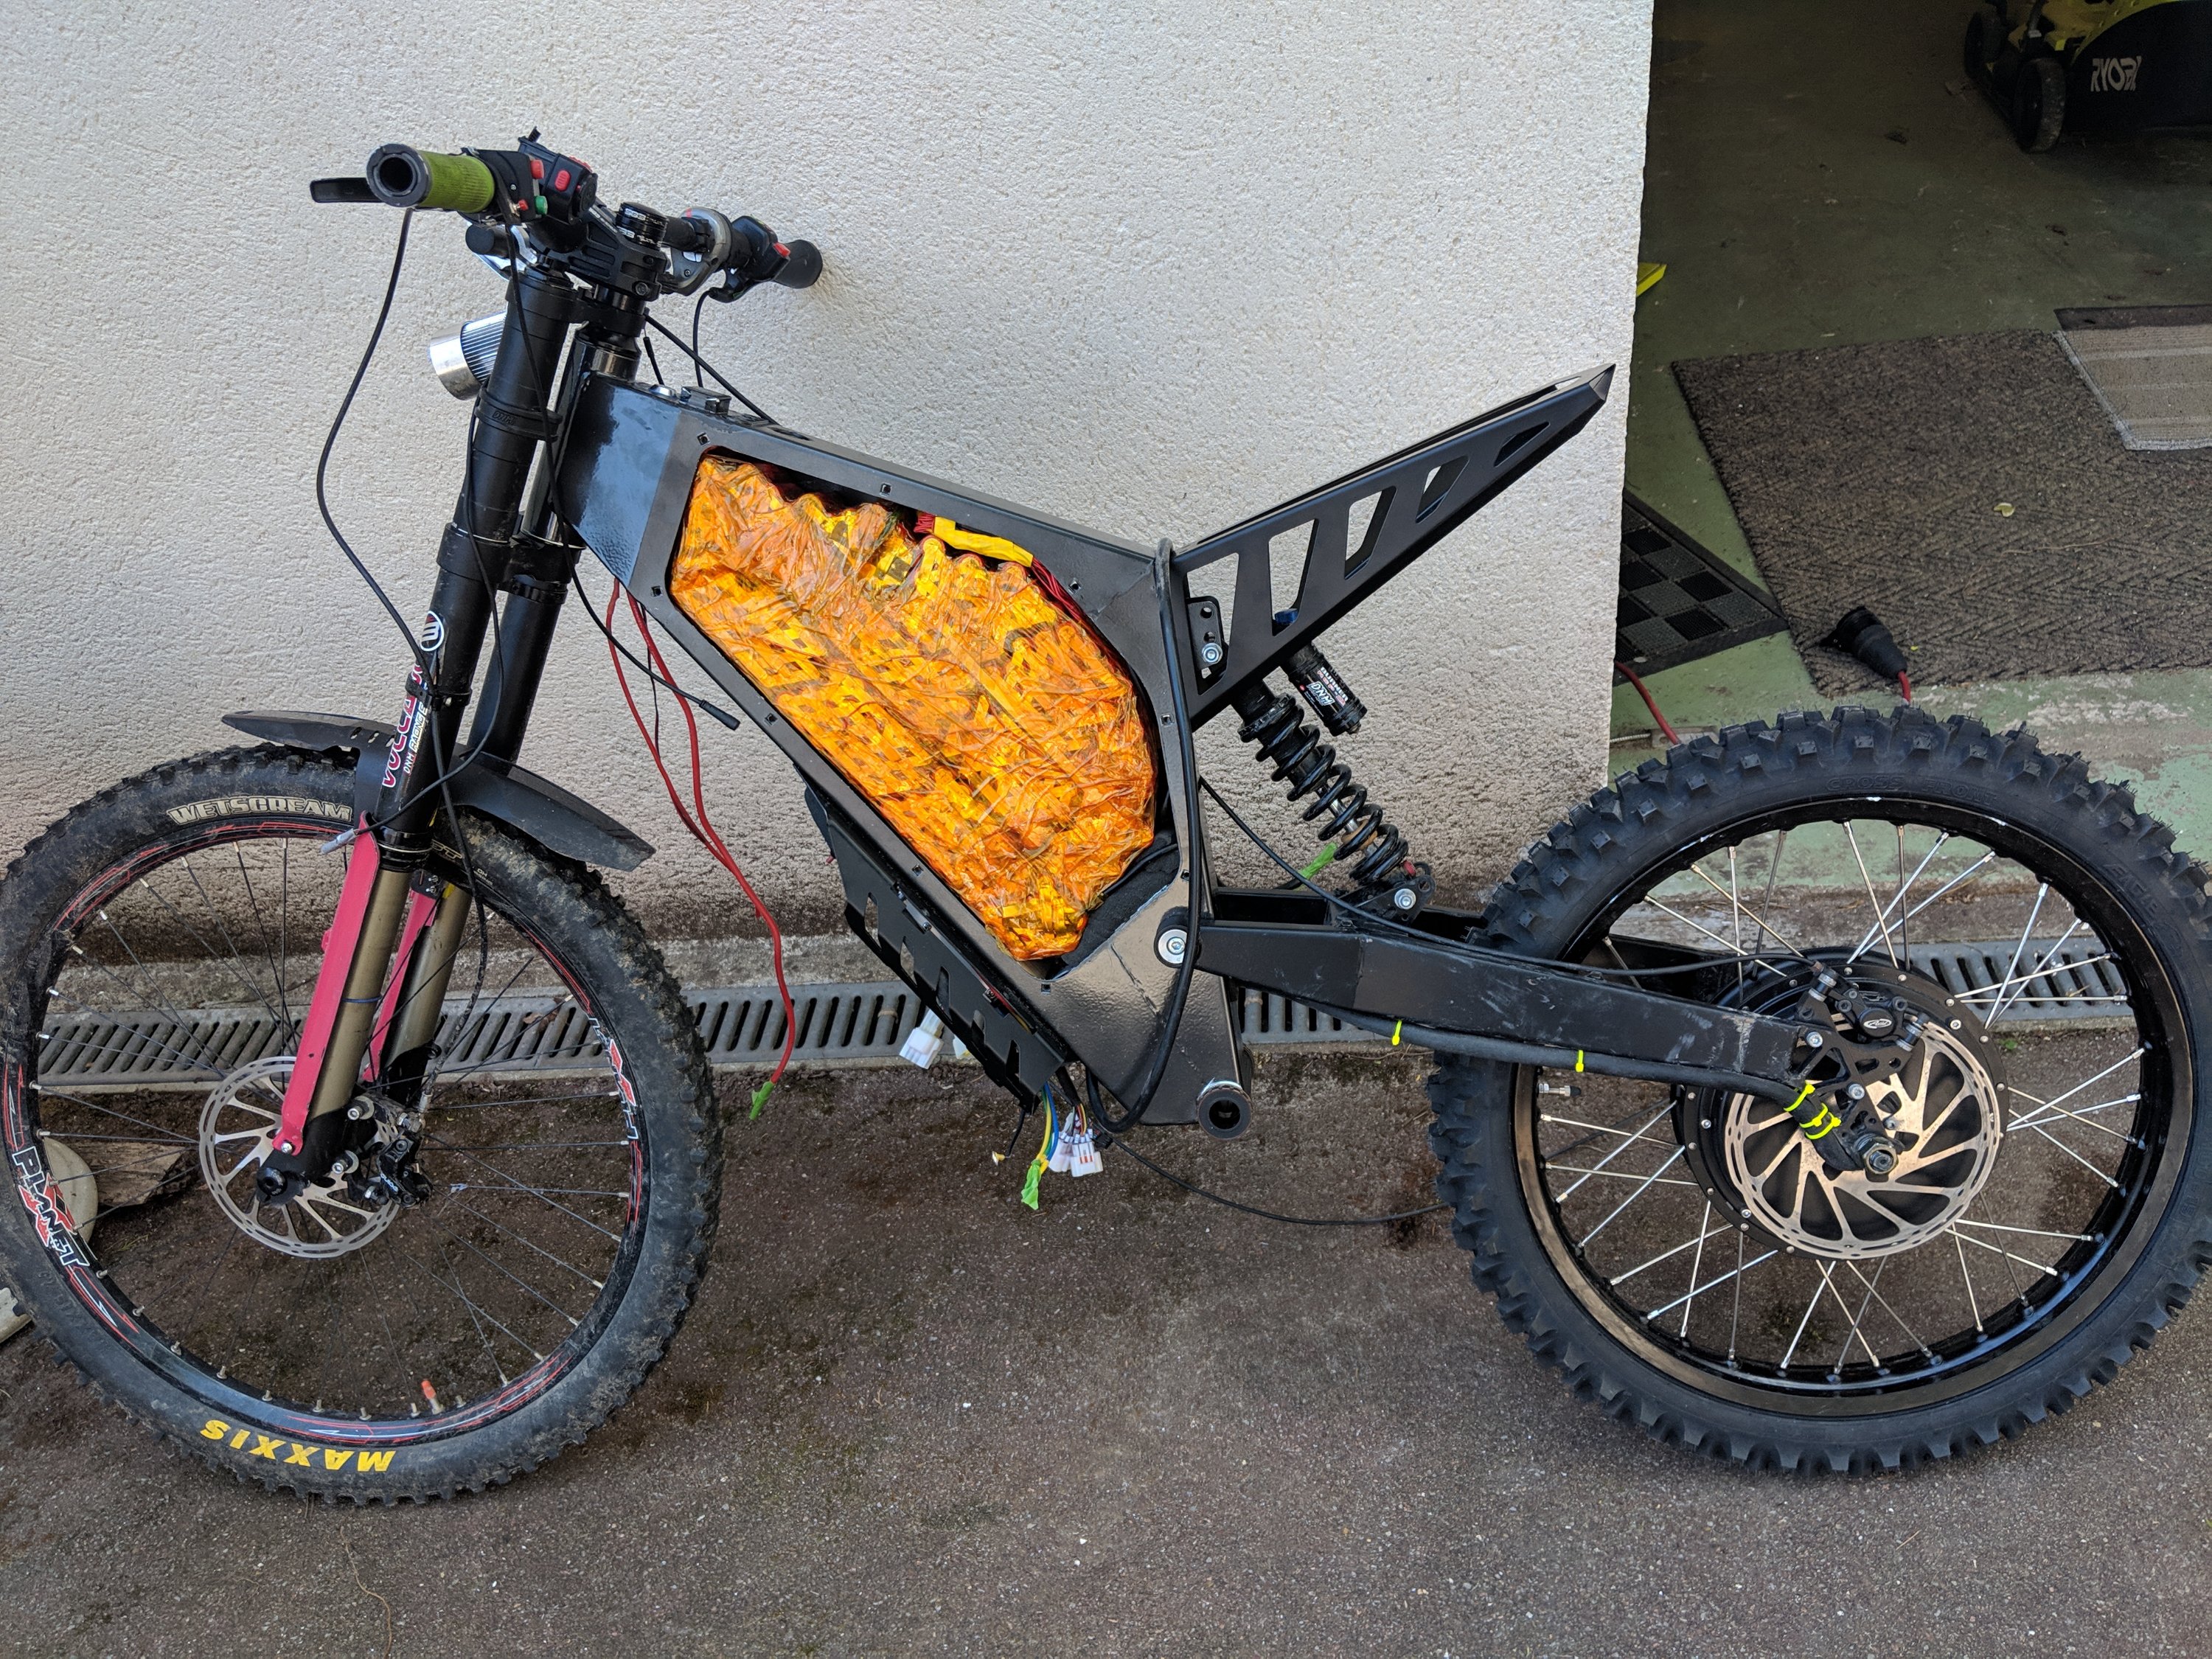
    En charge avec panneau latéral ouvert

    Ben même en mode éco (j’ai pas encore soudé le switch permettant de changer en full speed). Je ne suis jamais allé a fond. J’avais peur que de laisser un gros moteur sur la roue arrière ne fasse perdre du couple par rapport a des designs avec moteur central tel que le sur-ron mais finalement, et toujours en mode éco, j’en ai plus qu’avant malgré la roue plus grosse, le poids plus élevé (52kg). Les repose-pieds aident bien au maintient de l’équilibre, plus que les pédales.

    Au final, je pense que j’ai plus de couple et de vitesse max qu’une super soco TC que j’avais testé et que je lorgnais depuis un moment, et ça se rapproche plus d’un sur-ron, sauf que c’est totalement silencieux contrairement à la sur-ron (que j’ai testé aussi) qui a un entraînement par chaîne. Le rapport poids/puissance aide bien.

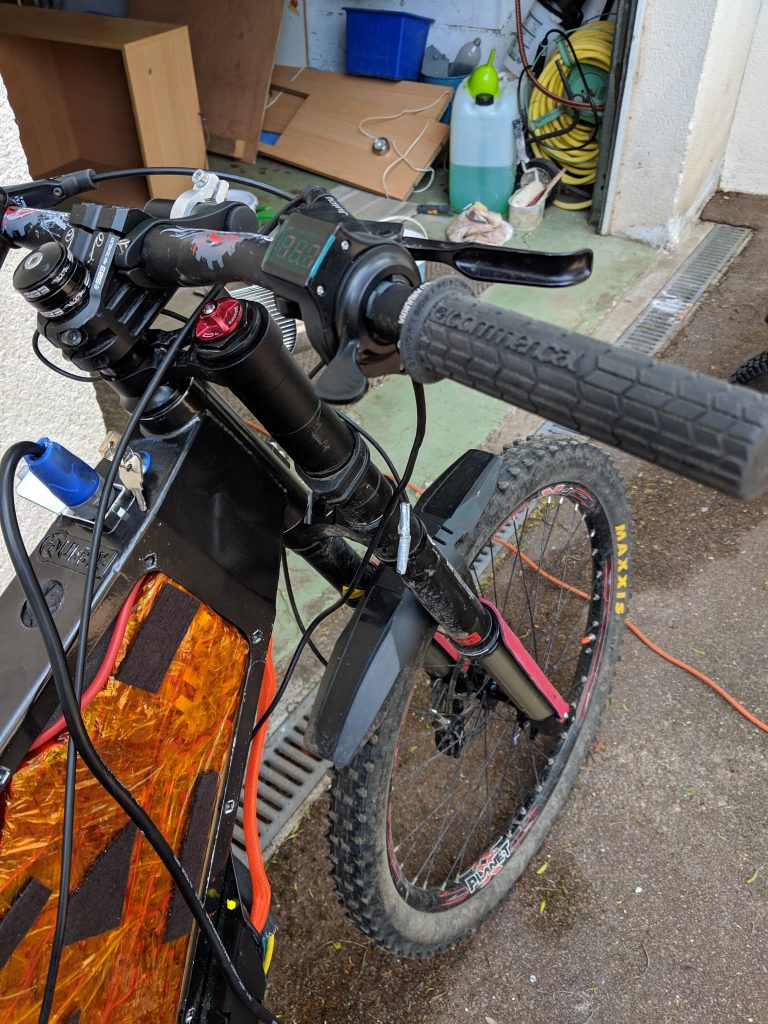
    Guidon épuré avec juste une gâchette de gaz et une visu du voltage

    J’ai viré les poignées tournantes pour le gaz : j’ai jamais aimé, ça casse le poignet. Ici on a bien le guidon en main. J’ai mis les freins dans le bon sens : avant a gauche, arrière a droite ! Le frein arrière fait un drôle de bruit (mais freine fort) : je pense que mes juicy 3 ont finalement rendus l’âme et j’attends des Magura mt5 4 pistons.

    Switch de phare

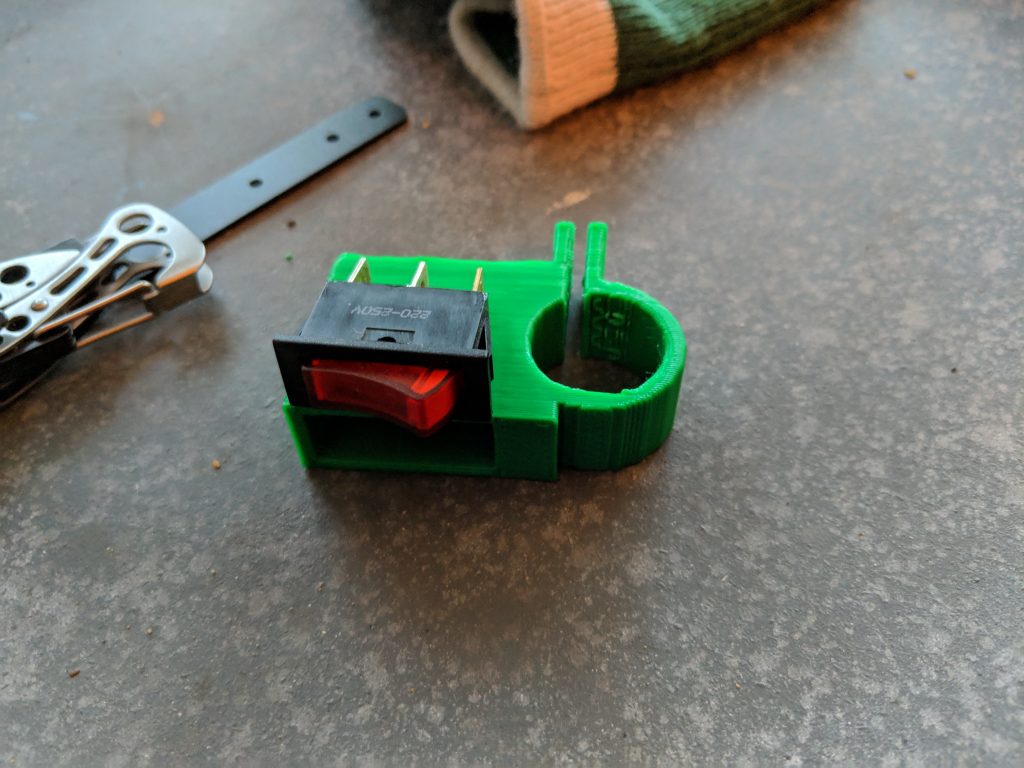
    Le phare avant n’est pas encore câblé. Je me suis 3d imprimé un truc pour le mettre sur le guidon que je compte peindre en noir

    Voilà !

  • Qulbix : update

    Enfin fini de trifouiller la batterie, je peux maintenant avancer un peu sur la partie cycle

    C’était marrant de monter la roue arrière avec les démonte-pneu de moto. Beaucoup plus facile que les truc minuscules prévu pour les vélo, pour peu qu’on ai vu les tutos pour le faire correctement (j’ai tout de même réussi a percer une chambre à air avant de voir lesdits tutos).

    Le reste est beaucoup plus facile a monter-remonter-demonter a force d’habitude.

    Il me reste quelques branchements a faire la semaine prochaine et je pourrais faire le premier test.