Générer des vidéos IA via des API cloud coûte vite très cher : dès qu’il faut ajuster un cadrage, corriger une expression ou relancer un plan qui déraille, la facture grimpe à chaque seconde générée. Impossible d’itérer sereinement comme un vrai monteur quand chaque essai brûle des crédits.
Pour contourner le problème, j’ai monté une usine de production de micro-dramas verticaux (9:16) pensée pour tourner presque intégralement en local sur mon propre GPU. Résultat : le rendu vidéo, les images de référence, l’animation 3D, le contrôle qualité et le montage final ne coûtent 0 € de rendu. On peut tester dix seeds, refaire un raccord ou polir une scène sans regarder le compteur.
Un exemple concret sorti du pipeline
Voici un exemple d’épisode vertical généré avec cette chaîne de production locale (Cyber Scavengers : assistance 0 kilomètres) :
Presque tout en local : où va (et ne va pas) le budget
Sur un pipeline vidéo IA, ce qui ruine habituellement le budget, ce sont les multiples passes de génération vidéo et d’images. Ici, toute la mécanique lourde tourne à la maison sur GPU (24 Go de VRAM) avec ComfyUI et la suite MiniMax H3 (Image et Vidéo) :
- Génération des images d’assets (16 MP natifs) : 100 % local, 0 €.
- Prévisualisation 3D & caméras complexes (Blender Cycles OptiX) : 100 % local, 0 €.
- Rendu vidéo double passe + accélération spectrale DiT : 100 % local, 0 €.
- Arbitrage vocal (Whisper), séparation d’ambiance (Demucs) et montage/étalonnage (FFmpeg) : 100 % local, 0 €.
- Contrôle qualité visuel sur planches contact : 100 % local, 0 €.
La seule micro-brique qui peut sortir à l’extérieur reste la synthèse vocale (TTS) pour obtenir un français vraiment naturel et expressif — soit quelques fractions de centime par épisode, avec les agents de rédaction pilotés dans mon environnement de développement existant. Le coût marginal de fabrication d’un épisode tombe donc quasiment à zéro.
L’équipe d’agents spécialisés
Au lieu de demander à un modèle unique de tout improviser, le travail est découpé entre plusieurs agents spécialisés, chacun avec une fiche de poste stricte :
drama-writer(le Scénariste) : transforme un pitch en découpage plan par plan. Il applique la règle du Show, Don’t Tell, impose une causalité dramatique entre chaque plan (« donc / mais » plutôt que « et puis ») et compte réellement les mots de chaque réplique pour respecter le barème temporel du plan.script-doctor(l’Auditeur narratif) : relit impitoyablement le script avant le moindre calcul GPU. Il applique le « test du film muet », sabre les dialogues redondants, supprime les formulations négatives (qui piègent les modèles de diffusion) et vérifie les règles de mise en scène (cadrages trois-quarts sur les gros plans, zéro regard direct vers l’objectif).dramagenerator(l’Orchestrateur de production) : traduit le scénario validé en prompts multimodaux structurés (ancrage des personnages, décors, objets clés, jeu d’acteur observable, ambiance sonore diégétique) et pilote le moteur CLI en double passe.render-qc(le Contrôleur qualité visuel) : après rendu local, il extrait des planches contact via FFmpeg et inspecte les images une par une. Il vérifie l’identité des visages, l’anatomie des mains, les raccords gauche/droite et la cohérence des accessoires, puis rend un verdict plan par plan sans envoyer d’images vers un service externe.
Les grandes étapes du workflow (et exemples d’assets)
1. Découpage calibré & Audit Script Doctor
Chaque épisode est découpé en plans courts (3,5 à 7,5 secondes) avec un barème phonétique strict (par exemple 5 à 7 mots pour 3,5–4 s, 8 à 10 mots pour 5 s) pour garantir qu’aucune fin de phrase ne soit tronquée. Un vérificateur statique (linter) valide ensuite le scénario Markdown avant de démarrer le GPU.
2. Bible visuelle générée en local (16 MP natifs)
Pour éviter que les personnages ne changent de visage d’un plan à l’autre, on génère d’abord toutes les références visuelles en local avec MiniMax H3 Image (en 16 mégapixels natifs, 6 steps, puis redimensionnement propre) :
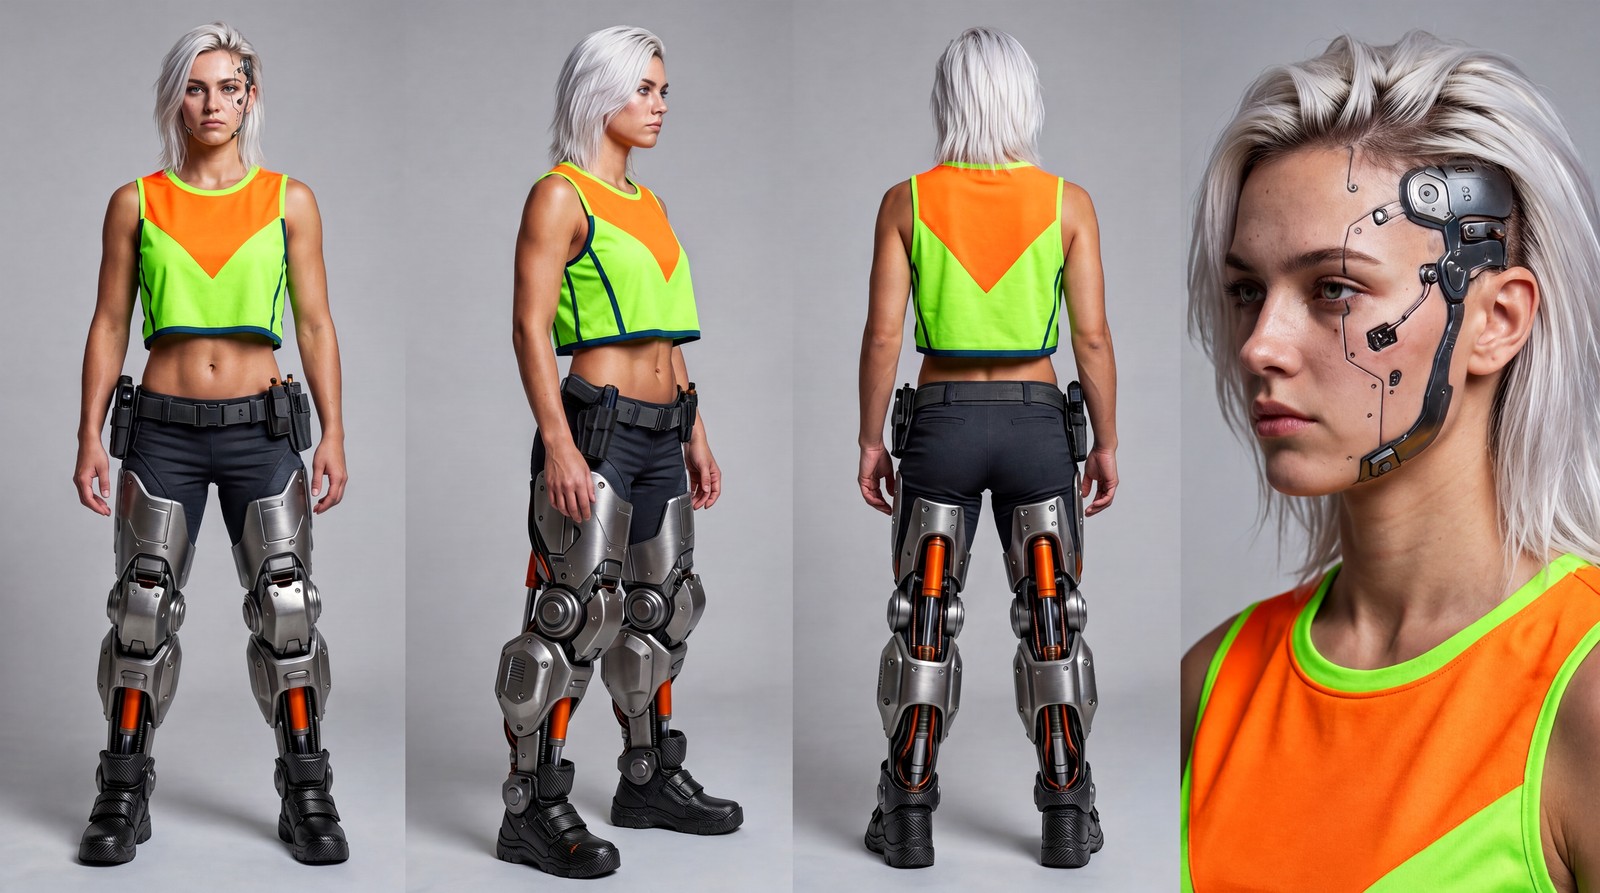
- Les character sheets sans fond : vue de face, trois-quarts, dos et gros plan visage pour verrouiller tenues, coiffures et détails.
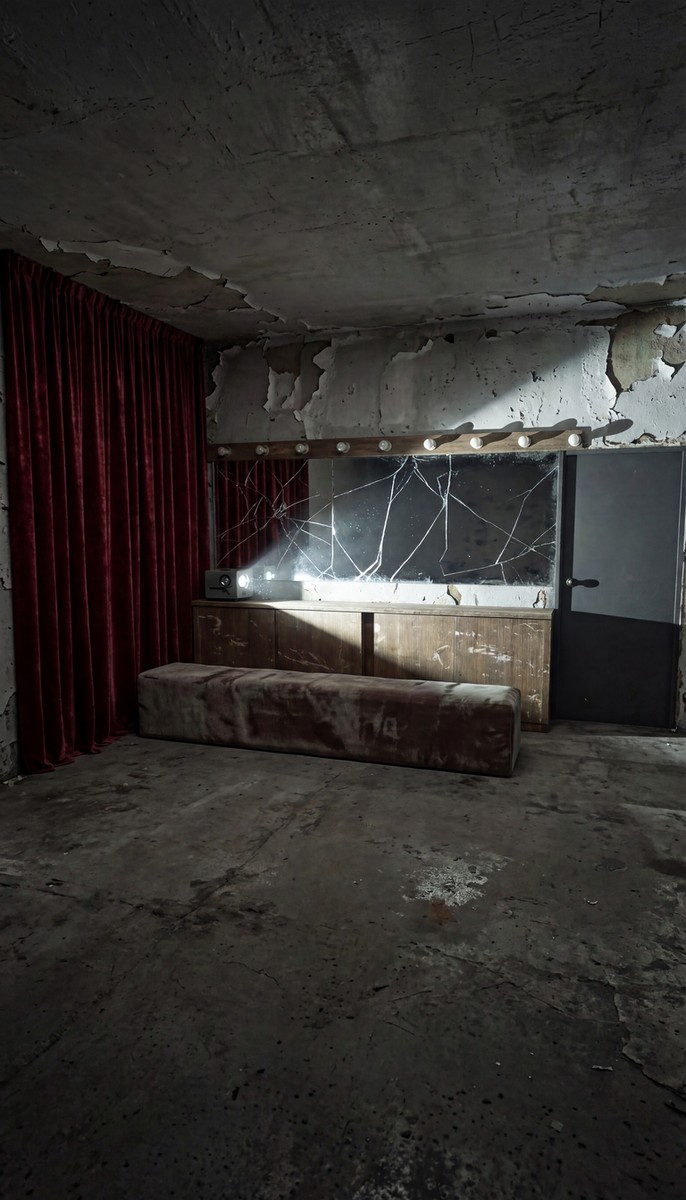
- Le décor vide (9:16) : une vue d’architecture et de lumière sans personnage, qui sert d’ancre spatiale à toute la scène.
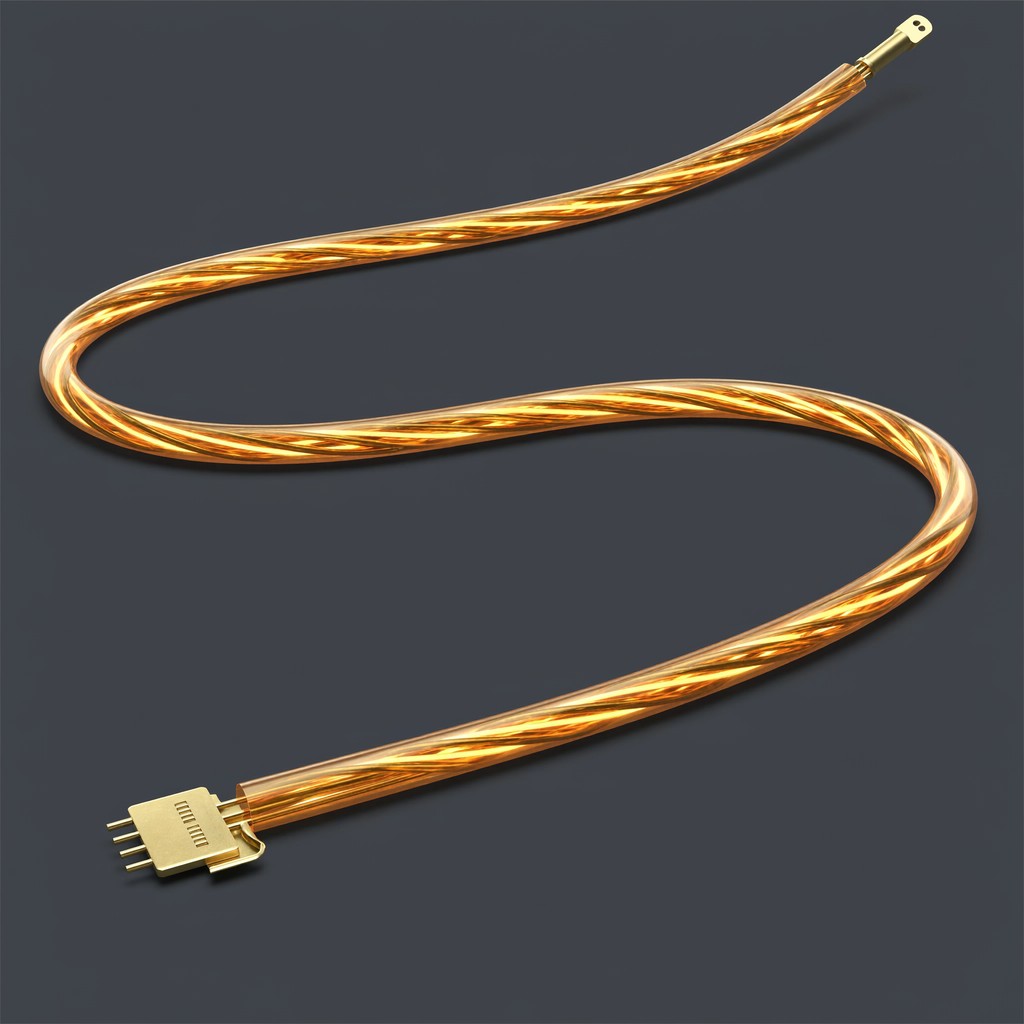
- Les objets narratifs clés (props) : dès qu’un personnage manipule un objet important, il reçoit sa propre image de référence afin d’éviter que le modèle ne projette par erreur les traits de l’acteur sur l’objet.
3. Voix de référence & Blocking 3D local
Chaque réplique est générée en plusieurs prises vocales avec direction d’acteur, puis Whisper tourne en local pour sélectionner automatiquement la prise la plus propre et la mieux articulée.
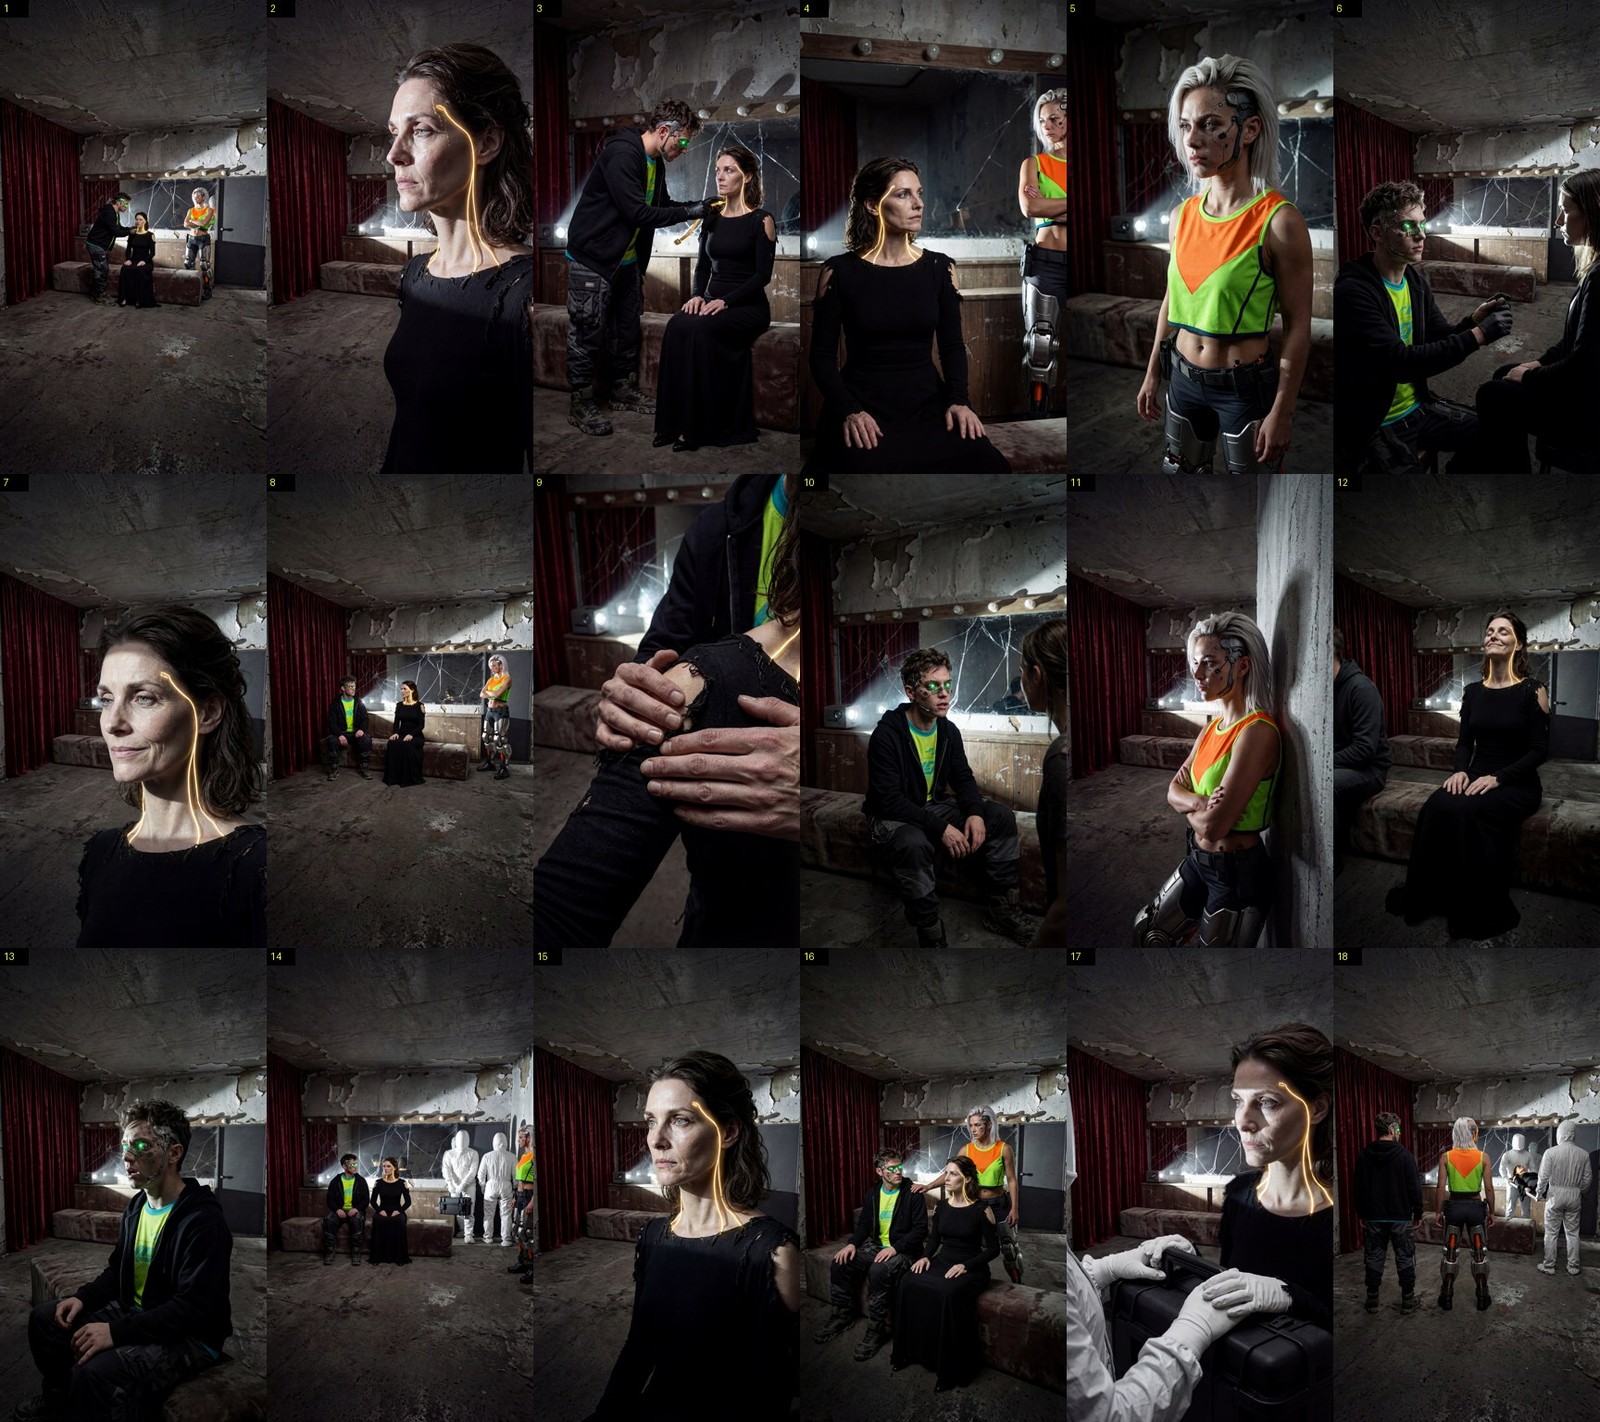
En parallèle, pour les scènes multi-personnages ou les mouvements de caméra complexes, un pré-découpage 3D rapide sous Blender en mode headless (rendu GPU local) permet de poser les positions gauche/droite et de générer les images d’ancrage de début et de fin de chaque plan. On obtient ainsi une continuité solide sur 18 plans d’affilée avant même le rendu vidéo final :
4. Passe 1 — Prévisualisation rapide (8 steps Turbo)
Le pipeline lance une première passe rapide en 8 steps (Turbo LoRA) sur ComfyUI. Les plans consécutifs utilisent une continuation latente masquée pour fluidifier les raccords, un détecteur automatique relance les plans qui sautent en milieu de clip, et l’agent render-qc inspecte les planches contact. Dès qu’un plan est bon, son prompt et son seed gagnant sont verrouillés.
5. Passe 2 — Master Final (20 steps + Spectrum DiT)
Seuls les plans verrouillés passent en 20 steps haute fidélité, avec l’accélération spectrale DiT Spectrum activée par défaut pour diviser le temps de calcul par deux sans sacrifier le piqué. Le modèle vidéo se cale sur la piste audio de référence (Ref2VA) pour le lip-sync, tandis que Demucs en local sépare et conserve les bruits d’ambiance diégétiques générés par la scène.
6. Montage, étalonnage et grain argentique (FFmpeg)
La dernière étape assemble les plans localement via FFmpeg : transitions fluides, étalonnage colorimétrique cinéma et ajout d’un léger grain argentique calibré en post-production (jamais demandé dans le prompt texte pour garder des visages propres), puis incrustation des sous-titres verticaux.
Conclusion
Le vrai luxe d’un pipeline presque 100 % local, ce n’est pas seulement d’économiser des centaines d’euros de crédits vidéo : c’est de retrouver le droit à l’essai-erreur. Quand relancer un plan ne coûte rien, on ne se contente plus du premier rendu passable — on peut vraiment réaliser et monter son histoire jusqu’à trouver le bon rythme.
Leave a Reply